
- 작성일
CH3. 컴퓨터의 구성과 자료처리
- Authors

- Name
- seren-wib
Contents
- 3.1 컴퓨터의 구성과 자료처리
- 3.1.1 컴퓨터 구조
- 3.2 기계어
- 3.2.1 기계어와 기계 명령
- 3.2.2 기계 명령의 종류
- 3.2.3 RISC와 CISC
- 3.2.4 가상 기계어
- 3.3 프로그램의 실행
- 3.4 연산 명령
- 3.4.1 논리 연산
- 3.4.2 자리이동과 회전 연산
- 3.4.3 산술 연산
- 3.4.4 연산 결과와 상태 정보
- 3.5 I/O 제어와 데이터 전송
- 3.5.1 I/O 제어기와 주변장치
- 3.5.2 CPU와 I/O 제어기의 통신
- 3.5.3 장치 간 데이터 전송과 Handshaking
- 3.5.4 직렬·병렬 통신과 I/O 인터페이스
- 3.5.5 Polling과 Interrupt
- 3.5.6 DMA(Direct Memory Access)
- 3.5.7 시스템 자원 공유와 DMA의 한계
3.1 컴퓨터의 구성과 자료처리
컴퓨터의 구성 → 기억장치 계층 → 데이터 처리 과정 → 저장 프로그램 방식
3.1.1 컴퓨터 구조
1. 컴퓨터의 구성과 CPU
컴퓨터의 구성
요소 역할 CPU 명령어를 해석·실행하고 데이터를 처리 주기억장치 실행 중인 프로그램과 데이터 저장 입출력장치 외부와 데이터를 주고받음 버스(Bus) 구성요소 사이에서 정보 전달 CPU
- 핵심 역할: 명령어 실행, 데이터 처리, 동작 제어
구성요소 역할 제어장치(Control Unit) 명령어 해석, 동작 순서를 제어하는 신호 생성 연산장치(ALU) 산술·논리·비교·비트 이동 연산 수행 레지스터(Register) 즉시 사용할 값과 중간 결과를 임시 저장 - 예시: c = a + b라면 제어장치가 값을 가져오고 덧셈하도록 지시하고, 레지스터가 a, b를 보관하고, ALU가 더한 뒤 결과를 레지스터에 넣는다.
레지스터
사용 이유: 주기억장치보다 훨씬 빠르기 때문에
범용 레지스터: 변수 값, 계산 결과 등 다양한 용도로 사용
특수 목적 레지스터: 정해진 역할 수행. 예를 들어 PC, IR 등이 있다.
특수 목적 레지스터 저장하는 내용 PC(Program Counter) 다음에 가져올 명령어의 주소 IR(Instruction Register) 현재 해석하거나 실행 중인 명령어 자체 - PC가 가리키는 주소에서 명령어를 가져와 IR에 넣고 해석한다.
- PC는 일반적으로 다음 명령어 주소로 바뀌지만, 분기하면 다른 주소로 바뀔 수 있다.
2. 컴퓨터의 기억장치 계층
계층 표
- 기억장치는 속도·용량·비트당 가격이 서로 트레이드오프 → 여러 종류를 계층적으로 구성
- CPU에 가까울수록 빠르고 작고 비쌈, 멀수록 느리고 크고 쌈 → 자주 쓰는 데이터는 CPU 가까이
계층 CPU와 거리 속도 용량 비트당 비용 레지스터 가장 가까움 가장 빠름 가장 작음 가장 비쌈 캐시 메모리 매우 가까움 매우 빠름 작음 비쌈 주기억장치 중간 빠름 큼 중간 보조기억장치 멂 상대적으로 느림 매우 큼 저렴 캐시 메모리(Cache Memory): CPU 칩 내부의 고속 메모리
- 자주 쓸 명령어·데이터의 복사본을 임시 저장
- 주기억장치 접근 횟수를 줄여 CPU와 주기억장치의 속도 차이를 완화
캐시 히트 / 미스: 데이터 필요 시 CPU → 캐시 먼저 확인
- Cache Hit: 캐시에 있음 → 바로 사용
- Cache Miss: 없음 → 하위 캐시나 주기억장치에서 가져옴
지역성(Locality): 최근 또는 인접한 데이터를 다시 쓸 가능성이 높은 성질. 캐시가 잘 동작하는 이유
- 시간 지역성(Temporal): 최근 쓴 데이터는 곧 다시 씀. 예: 반복문 카운터 i
- 공간 지역성(Spatial): 어떤 위치를 쓰면 그 주변도 곧 씀. 예: 배열 순차 탐색
- 배열은 연속 저장 → arr[0] 읽을 때 주변 원소도 캐시로 옴 → arr[1], arr[2]는 Hit
- 연산 횟수가 같아도 메모리 접근 방식에 따라 실행 시간이 달라짐
L1 / L2 / L3
구분 위치·특징 속도 용량 L1 각 코어에 가장 가까움 가장 빠름 가장 작음 L2 보통 각 코어 가까이 빠름 L1보다 큼 L3 보통 여러 코어가 공유 상대적으로 느림 가장 큼 - L1 → L2 → L3 → DRAM 갈수록 느려지고 커짐 (실제 구성은 CPU 설계마다 다름)
3. 데이터 연산처리 과정
데이터 연산의 기본 흐름: CPU가 계산하려면 데이터를 CPU 내부로 가져와야 함
- 캐시 확인: 있으면 Cache Hit → 바로 사용, 없으면 Cache Miss → 주기억장치(DRAM)에서 가져옴
- 레지스터에 저장: ALU는 레지스터 값만 갖고 계산
- ALU에서 연산: 제어장치가 수행할 연산 결정, ALU가 레지스터 데이터로 계산
- 결과 저장: 먼저 레지스터에 들어간다. 필요 시 캐시, 주기억장치에 반영
- 데이터 이동 경로: 주기억장치 ↔ 캐시 ↔ 레지스터 ↔ ALU
버스(Bus): CPU, 기억장치, 입출력 장치 사이에 정보 전달하는 공용 통신 경로, 데이터, 주소, 제어 신호도 다닌다.
- 주소 버스(어느 칸), 데이터 버스(값), 제어 버스(read/write 신호)
메모리 읽기: CPU -버스(read 신호, 주소)-> DRAM -버스(데이터)-> CPU
메모리 쓰기: CPU -버스(write 신호, 주소, 데이터)-> DRAM
- 읽기는 데이터가 DRAM에서 돌아오고, 쓰기는 CPU가 다 보내고 끝
폰 노이만 구조(Von Neumann Architecture): 프로그램과 데이터를 같은 주기억장치에 저장하고 CPU가 순차적으로 가져와 처리하는 구조
- 폰 노이만 병목(Bottleneck): CPU 처리 속도에 비해 메모리 접근이 느리면 CPU가 데이터를 기다리는 시간 발생
3.2 기계어
CPU는 비트패턴으로 표현된 명령어를 해석하고 실행
3.2.1 기계어와 기계 명령
기계어(Machine Language): CPU가 직접 이해하고 실행할 수 있는 명령어
기계 명령(Machine Instruction): CPU가 수행하는 하나의 기본 작업
기계 명령 구조: 무엇을 할지 + 어떤 데이터를 대상으로 할지
구성 의미 예 연산 코드(Opcode) 수행할 동작의 종류 데이터 이동, 저장, 연산, 분기 피연산자(Operand) 명령을 수행할 대상 정보 데이터, 레지스터 번호, 기억장치 주소 - 예:
ADD R3, R1, R2→ ADD: 덧셈(Opcode), R1·R2: 입력 피연산자, R3: 결과 저장할 목적지 레지스터
- 예:
3.2.2 기계 명령의 종류
데이터 이동 명령(Data Transfer)
- 원래 데이터가 없어지는 게 아니라 값이 복사됨
- LOAD: 메모리 → 레지스터 (
LOAD R1, [A]) - STORE: 레지스터 → 메모리 (
STORE R1, [C]) - MOVE(MOV): 레지스터 사이 복사 (
MOV R2, R1: R1 값을 R2로) - I/O 명령: 키보드·디스크·네트워크 장치와 데이터 주고받음. ISA와 시스템에 따라 처리 방식 다름
산술·논리 명령(Arithmetic / Logic)
- ADD / SUB, MUL / DIV: 사칙연산 (
ADD R3, R1, R2: R3 ← R1 + R2) - AND / OR / XOR: 비트 단위 논리 연산
- SHIFT: 비트를 왼쪽/오른쪽으로 이동
- ROTATE: 밀려난 비트를 반대쪽으로 다시 넣음
- ADD / SUB, MUL / DIV: 사칙연산 (
제어 명령(Control): 프로그램 실행 순서 변경
- 조건부 분기(Conditional Branch): 조건에 따라 다음 명령 변경. C의 if, while, for 구현
- 무조건 분기(Unconditional Jump): 조건 없이 지정 위치로 이동. 함수 호출, 반복·분기 구조
- 프로그램 실행 종료(HALT)
덧셈 예 C = A + B: Memory A/B → Registers → ADD → Register → Memory C
단계 명령 메모리 A를 R1으로 LOAD R1, [A]메모리 B를 R2로 LOAD R2, [B]R1 + R2 → R3 ADD R3, R1, R2R3를 메모리 C에 STORE R3, [C]멈춤 HALT나눗셈 예 C = A / B: Memory A, B → Registers → 0 검사 → DIV → Register → Memory C
단계 명령 메모리 A를 R1으로 LOAD R1, [A]메모리 B를 R2로 LOAD R2, [B]R2가 0이면 오류 처리로 이동 JUMP R2, DIV_ZEROR1 / R2 → R3 DIV R3, R1, R2R3를 메모리 C에 STORE R3, [C]멈춤 HALTC 코드 한 문장도 여러 개의 기계 명령으로 나뉘어 실행됨
3.2.3 RISC와 CISC
ISA(Instruction Set Architecture, 명령어 집합 아키텍처): CPU와 프로그램 사이의 약속
CPU 명령어 설계의 두 접근 방식
- RISC(Reduced Instruction Set Computer): 단순하고 규칙적인 명령어 중심
- CISC(Complex Instruction Set Computer): 다양하고 복합적인 명령어 지원
ARM 아키텍처: Arm이 개발한 RISC 계열 ISA. 에너지 효율 중시, 현대 대표 RISC 계열
3.2.4 가상 기계어
가상 컴퓨터 구성
- 주기억장치 256개 셀, 주소 00 ~ FF
- 범용 레지스터 16개, 번호 0 ~ F. 그 외 PC, 명령 레지스터(IR)
- 명령어 길이 16비트 = 2바이트 = 16진수 4자리
명령어 구조
- 16진수 한 자리 = 4비트
- 명령 코드(op-code): 처음 4비트, 어느 명령인지 (16개 명령 가능)
- 피연산자(operand): 나머지 12비트 = 4비트(레지스터 번호) + 8비트(메모리 주소/값)
비트 위치 15 ~ 12 11 ~ 8 7 ~ 0 필드 op-code 레지스터 주소/값 35A7 0011 (3) STORE 0101 (5) R5 1010 0111 (A7) 명령 형식 의미 1RXY LOAD R, MEM R ← 주소 XY의 값 2RXY LOAD R, VAL R ← 값 XY (1바이트) 3RXY STORE R, MEM 주소 XY ← R의 값 40RS MOVE R, S S ← R의 값 5RST ADD R, S, T R ← S + T (2의 보수 덧셈) 6RST ADDF R, S, T R ← S + T (부동소수점 덧셈) 7RST OR R, S, T R ← S OR T 8RST AND R, S, T R ← S AND T 9RST XOR R, S, T R ← S XOR T AR0X ROT R, X R을 X비트만큼 rotate right BRXY JUMP R, ADDR R = R0이면 주소 XY로 분기 B0XY 무조건 분기 주소 XY로 분기 (R0 = R0이라 항상 참) C000 HALT 중단 해석 예
- 35A7: 3 = STORE, 5 = 레지스터 5, A7 = 주소 → 5번 레지스터 내용을 주소 A7에 저장
- B34C: 3번 레지스터가 0번 레지스터와 같으면 주소 4C로 분기
- B04C: 무조건 주소 4C로 분기
- 분기가 실행되면 PC가 순차 증가 대신 지정된 주소로 변경됨
사용 예: c = a + b
기계 명령 설명 156C 주소 6C의 값을 5번 레지스터에 LOAD 166D 주소 6D의 값을 6번 레지스터에 LOAD 5056 5번 + 6번 (2의 보수 덧셈) → 0번 레지스터 306E 0번 레지스터 값을 주소 6E에 STORE(store의 목적지는 항상 메모리) C000 멈춤 해독 순서: Opcode 확인 → 필드 분리 → 레지스터/주소 해석 → 데이터 흐름 추적
3.3 프로그램의 실행
프로그램은 주기억장치에 적재된 뒤 PC가 가리키는 명령어를 한 번에 하나씩 인출·해석·실행하며 진행
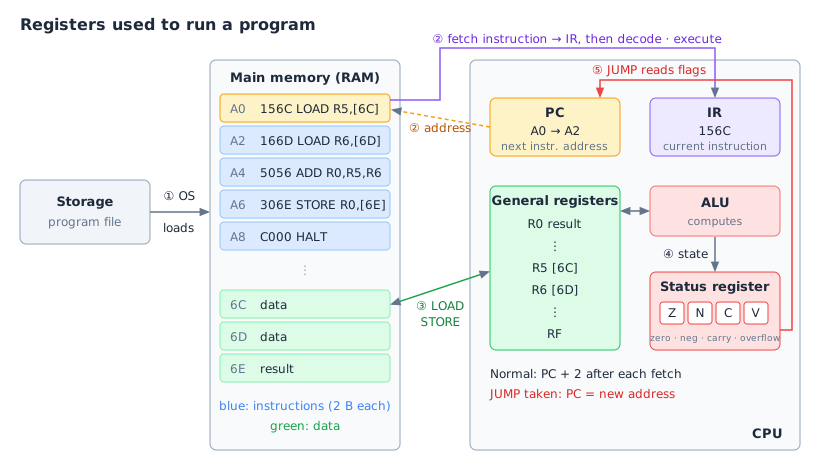
① 실행 요청 → OS가 RAM에 적재
② 기계 주기: 인출 → 해석 → 실행 반복 (HALT까지)
- 인출(Fetch): PC가 가리키는 주소의 명령어 → IR, PC는 바로 +2 (명령어 2B, 셀 1B라 두 칸)
- 해석(Decode): 제어장치가 IR 맨 앞 op-code 보고 할 일 결정 (예:
1→ LOAD) - 실행(Execute): 실제 동작 (데이터 이동, 연산, 저장, 분기)
③ 연산할 값이랑 결과는 범용 레지스터 (RAM ↔ 레지스터는 LOAD·STORE)
④ 연산 결과가 0·음수·자리올림·오버플로인지는 상태 레지스터 플래그(Z·N·C·V)에 기록
⑤ 분기: JUMP가 플래그 보고 PC를 다른 주소로 바꿈 →
if,while, 함수 호출 전부 이걸로 구현- 흐름 제어 = PC를 어디로 바꿀지의 문제
예:
[6C] + [6D] → [6E]
| 시작 PC | 명령어 | 인출 후 | 해석 | 실행 |
|---|---|---|---|---|
A0 | 156C | PC=A2 | LOAD R5, [6C] | R5 ← [6C] |
A2 | 166D | PC=A4 | LOAD R6, [6D] | R6 ← [6D] |
A4 | 5056 | PC=A6 | ADD R0, R5, R6 | R0 ← R5 + R6 |
A6 | 306E | PC=A8 | STORE R0, [6E] | [6E] ← R0 |
A8 | C000 | PC=AA | HALT | 종료 |
3.4 연산 명령
CPU의 연산은 고정된 비트 수 안에서 ALU가 수행하는 비트패턴 변환 + 상태 플래그 기록 과정
연산 명령의 구분
구분 대표 명령 주요 용도 논리 연산 AND,OR,XOR,NOT특정 비트 검사·설정·반전 자리이동 연산 SHL,SHR,SAR,ROL,ROR비트 이동, 비트 조작 산술 연산 ADD,SUB,MUL,DIV정수 및 실수 계산 비교 연산 CMP,TEST조건 분기 전 결과 확인
3.4.1 논리 연산
논리 연산(Logical Operation): 각 비트 위치에 독립적으로 수행되는 연산. 숫자 크기 계산보다 비트 상태 조작에 사용
연산 결과가 1이 되는 조건 비트 마스킹(Masking) 활용 예 ( x = 01011001)AND ( &)두 비트가 모두 1 원하는 비트만 남기기(추출) / 나머지 0 제거 01011001 & 00001111 = 00001001(하위 4비트 추출)OR ( |)둘 중 하나 이상이 1 특정 비트를 1로 설정 01011001 | 10000000 = 11011001(최상위 비트 1 설정)XOR ( ^)두 비트가 서로 다름 특정 비트 반전(마스크가 1인 위치만 뒤집기), 값 비교 01011001 ^ 00000001 = 01011000(최하위 비트 반전)NOT ( ~)입력 비트의 반대 모든 비트 반전 ~01011001 = 10100110비트 상태 확인: 특정 비트가 0인지 1인지 스위치처럼 확인 (
AND사용)- 홀수·짝수 판별: 가장 오른쪽 비트(최하위 비트)를
n & 1로 확인 →1이면 홀수(0111 & 0001 = 0001),0이면 짝수(0110 & 0001 = 0000) - 활용: 장치 준비 상태 확인, 파일 접근 권한, 옵션 활성화 여부, 여러 참/거짓 상태를 정수 하나에 저장
- 홀수·짝수 판별: 가장 오른쪽 비트(최하위 비트)를
3.4.2 자리이동과 회전 연산
- 자리이동(Shift)과 회전(Rotate): 비트를 왼쪽/오른쪽으로 이동. 일반 Shift는 밀려난 비트를 버리고 빈자리를 채우며, Rotate는 밀려난 비트를 반대편 끝으로 다시 넣음
| 종류 | 방향·명령 | 빈자리 처리 | 효과 및 주 사용 대상 |
|---|---|---|---|
| 논리적 왼쪽 이동 | SHL (<<) | 오른쪽 빈자리에 항상 0 삽입 | 범위 내면 ×2 효과 (비트가 폭을 넘으면 상위 비트 소실 → 항상 2배는 아님) |
| 논리적 오른쪽 이동 | SHR (>>) | 왼쪽 빈자리에 항상 0 삽입 | unsigned 정수에서 ÷2 몫 효과 (54(00110110) >> 1 → 27(00011011)) |
| 산술적 오른쪽 이동 | SAR | 왼쪽 빈자리에 최상위 부호 비트(MSB) 복제 | signed(2의 보수) 정수의 부호 유지 + ÷2 효과 (-12(11110100) → -6(11111010)) |
| 왼쪽/오른쪽 회전 | ROL / ROR | 밀려난 비트를 반대쪽 끝으로 다시 삽입 | 비트 재배치, 암호화 비트 혼합, 해시 함수 (ROL: MSB→LSB, ROR: LSB→MSB) |
3.4.3 산술 연산
정수 사칙연산: 결국 이진 덧셈·뺄셈·자리이동의 조합
- 덧셈(
ADD): ALU가 각 비트의 합과 자리올림(carry) 계산 - 뺄셈(
SUB): 별도 뺄셈 회로 대신 2의 보수를 더해 덧셈 회로 재사용 (A - B = A + (-B)) - 곱셈(
MUL): 각 비트를 확인하며 왼쪽 이동 후 더하는 Shift + Add 방식 (예:13 × 5 = 13 × (4 + 1) = (13 << 2) + 13) - 나눗셈(
DIV): 나누는 값을 반복해서 빼며 몫 비트를 결정하는 Shift + Subtract 방식
- 덧셈(
예 (8비트)
뺄셈: 7 − 3
 3   = 00000011
-3   = 11111100 + 1 = 11111101   (반전 후 +1, 2의 보수)

  00000111   (7)
+ 11111101   (-3)
-----------
1 00000100   → 넘친 맨 앞 1은 버림 → 00000100 = 4
곱셈: 13 × 5
5 = 101 → 1이 있는 자리: 2² 자리, 2⁰ 자리
13 << 2 = 00110100   (52, 13×4)
13 << 0 = 00001101   (13, 13×1)
          --------
          01000001   (65)
나눗셈: 13 ÷ 5 (
1101 ÷ 101)1 < 101 → 몫 0 11 < 101 → 몫 0 110 ≥ 101 → 몫 1, 110 - 101 = 1 11 < 101 → 몫 0 몫 0010 = 2, 나머지 11 = 3정수 연산 vs 부동소수점 연산
구분 정수(Integer) 연산 ( 29 + 13)부동소수점(Floating Point) 연산 ( 3.14 + 2.75)표현 방식 정수 비트패턴 부호, 지수, 가수 처리 과정 이진 덧셈 중심 (직접 계산) 지수 크기 비교·맞춤(작은 쪽 가수 이동) → 가수 덧셈/뺄셈 → 결과 정규화 → 반올림 주요 문제 Overflow 반올림 오차, 정밀도 손실 ( 0.1 + 0.2 == 0.3이 참이 아닐 수 있는 이유)부동소수점 예 (
1.5 + 0.75)1.5 = 1.1 × 2⁰ 0.75 = 1.1 × 2⁻¹ 1) 지수 맞추기: 작은 쪽을 2⁰로 → 0.11 × 2⁰ (가수를 오른쪽으로 한 칸) 2) 가수 더하기: 1.10 + 0.11 = 10.01 × 2⁰ 3) 정규화: 1.001 × 2¹ (점을 한 칸 옮기고 지수 +1) = 2.25 ✓ 4) 반올림: 가수 칸이 소수점 아래 2비트뿐이면 1.001 → 1.00 → 2.0이 돼버려
3.4.4 연산 결과와 상태 정보
CPU는 signed인지 unsigned인지 모르고 비트만 더함 → 두 해석으로 "넘쳤냐"를 따로 기록
Carry: 더할 때 다음 자리로 올라가는 1
CF(Carry Flag): 부호 없는 수(0~255)로 봤을 때 넘쳤냐. 맨 왼쪽 비트 밖으로 1이 튀어 나가면 1
OF(Overflow Flag): 부호 있는 수(-128~127)로 봤을 때 넘쳤냐. 양수+양수=음수처럼 부호가 말 안 되게 뒤집히면 1
계산 비트 결과 unsigned로 보면 signed로 보면 CF OF 1 + 1000000102 → 정상 2 → 정상 0 0 255 + 100000000256이어야 하는데 0 → 넘침 -1 + 1 = 0 → 정상 1 0 127 + 110000000128 → 정상 128이어야 하는데 -128 → 넘침 0 1 128 + 12800000000256인데 0 → 넘침 -128 + -128 = 0 → 넘침 1 1
3.5 I/O 제어와 데이터 전송
I/O 제어기가 CPU 대신 장치를 다루고, Handshaking·인터페이스로 안정적으로 전송, Interrupt·DMA로 CPU 부담을 줄임
3.5.1 I/O 제어기와 주변장치
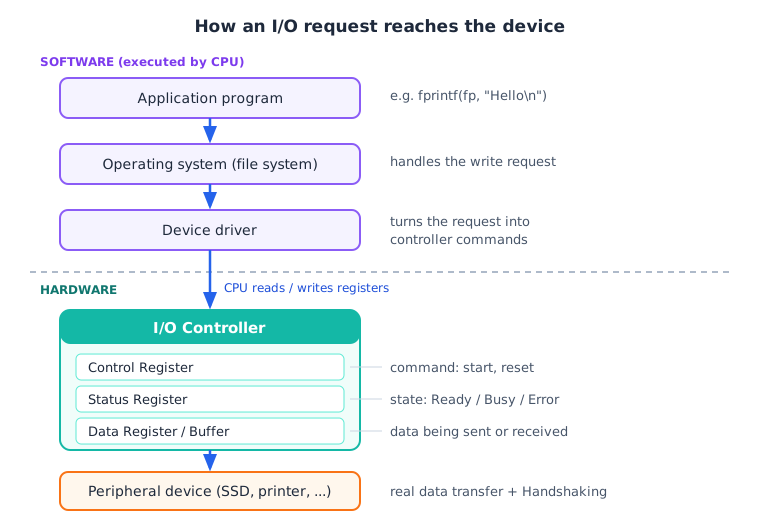
I/O 제어기(I/O Controller): CPU와 주변장치 사이에서 통신을 중개하는 하드웨어.
필요한 이유: 장치마다 데이터 형태·속도·동작 방식이 다름 → CPU가 다 직접 처리하면 제어 구조가 복잡해짐
I/O 요청 경로: 응용 프로그램 → 운영체제(파일 시스템) → 디바이스 드라이버 → I/O 제어기 → 주변장치
Controller vs Device Driver
구분 Controller Device Driver 정체 하드웨어 소프트웨어 위치 메인보드, 확장카드, 장치 내부 운영체제 내부 역할 장치와 실제 데이터 전송, 상태 관리 OS의 I/O 요청을 제어 명령으로 변환, 제어기 레지스터 접근 예 USB Controller, SSD Controller USB Driver, Printer Driver
3.5.2 CPU와 I/O 제어기의 통신
- 시스템 인터커넥트: CPU·메모리·I/O 제어기를 잇는 통신 경로. CPU는 여기를 통해 제어기 레지스터를 읽고 씀
- 제어기는 필요하면 Interrupt로 CPU에 상태 변화 알림
3.5.3 장치 간 데이터 전송과 Handshaking
- Handshaking: 두 장치가 제어 신호·상태 정보를 주고받아 언제 보내고 언제 받을지 맞추는 과정. 예: 프린터가 Ready일 때만 데이터 보냄
목적: 수신 준비 확인, 정상 전달 확인, 속도 다른 장치 간 전송 시점 조정, 데이터 손실·오류 방지
CPU에 완료 알리는 방법은 3.5.5 (Polling, Interrupt)
3.5.4 직렬·병렬 통신과 I/O 인터페이스
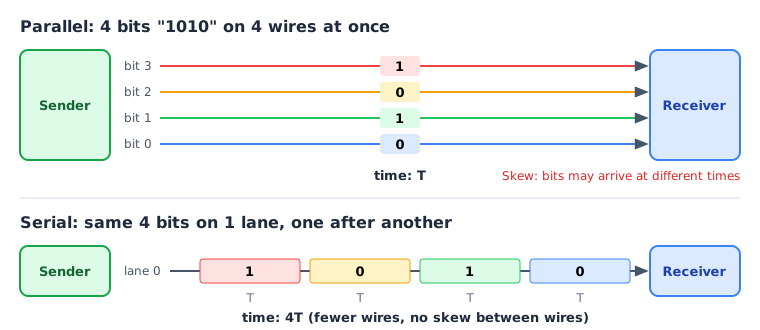
병렬 통신(Parallel): 여러 전송선으로 여러 비트를 동시에 보냄. 예: 선 8개면 한 번에 8비트
- Skew(동시에 출발한 비트들이 서로 다른 시점에 도착하는 현상) 발생 가능
직렬 통신(Serial): 하나의 경로(Lane)로 비트를 시간 순서대로 보냄
- Lane: 독립적인 직렬 통신 경로 하나. 여러 개를 같이 써서 대역폭 확장
Data Rate: 단위 시간 동안 통신 경로로 전송되는 데이터 양. 단위 bps (Kbps = 10³, Mbps = 10⁶, Gbps = 10⁹ bps)
- Maximum Data Rate: 인터페이스 규격의 이론상 최대 전송률
- Throughput: 실제 시스템에서 달성되는 전송률. Maximum Data Rate ≥ Throughput
USB(Universal Serial Bus): 주변장치 연결용 대표 직렬 인터페이스
FireWire(IEEE 1394): 고속 실시간 전송용 직렬 인터페이스
- Peer-to-Peer: 장치끼리 직접 통신. 예: 캠코더 ↔ 외장 저장장치
- 지금은 USB·Thunderbolt에 밀려 거의 안 씀
USB vs FireWire
구분 USB FireWire 기본 통신 방식 직렬 직렬 통신 관리 Host 중심 Peer-to-Peer 대표 활용 키보드, 마우스, 저장장치, 웹캠 예전 캠코더, 전문 오디오 장비 핵심 특징 범용성, 호환성, Plug and Play 실시간 멀티미디어 전송 - 핵심 차이는 속도보다 누가 통신을 시작하고 관리하냐
3.5.5 Polling과 Interrupt
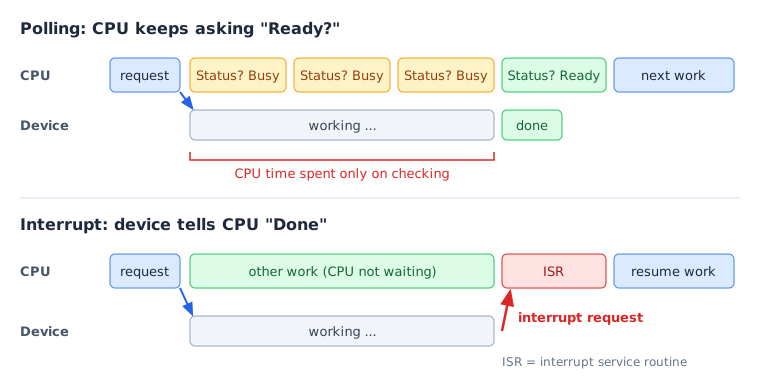
필요한 이유: CPU는 빠른데 I/O 장치는 느리고 완료 시간도 일정하지 않음 → CPU가 완료를 알 방법 필요
Polling vs Interrupt
구분 Polling Interrupt 완료 확인 CPU가 장치 상태를 반복 확인 장치가 CPU에 완료를 알림 CPU 대기 반복 확인에 CPU 시간 사용 다른 작업 가능 장점 구조 단순 CPU 활용 효율 높음 단점 장치 느리면 CPU 시간 낭비 인터럽트 처리 비용 적합한 상황 짧고 단순한 I/O 완료 시간이 길거나 예측 어려운 I/O - Interrupt를 써도 대량 데이터 전송 자체는 CPU가 직접 해야 하는 문제 남음 → 3.5.6 DMA
프린터 인쇄 전체 흐름
- 사용자가 응용 프로그램에서 인쇄 요청
- OS의 Print Spooler가 출력 작업을 Spool Queue에 저장
- OS가 Queue의 첫 작업 선택
- CPU가 Printer Driver 실행, 제어기 Status Register 확인
- 준비 상태면 출력 데이터를 Data Register / Buffer에 기록
- Control Register에 출력 시작 명령 기록
- 제어기가 프린터에 데이터·명령 전달, 프린터 출력
- 출력 끝나면 제어기가 Status Register 갱신 + Interrupt 발생
- OS가 완료 처리, Spool Queue 다음 작업 시작
3.5.6 DMA(Direct Memory Access)
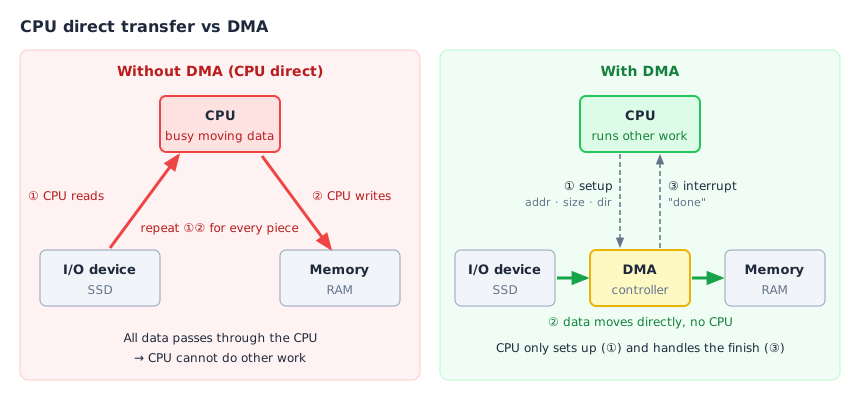
CPU 직접 전송 vs DMA
구분 CPU 직접 전송 DMA 전송 데이터 이동 CPU가 계속 관여 DMA가 수행 CPU 역할 하나하나 읽고 씀 전송 설정 + 완료 후 처리 대량 전송 시 CPU 부담 증가 CPU는 다른 명령 동시 수행 가능
3.5.7 시스템 자원 공유와 DMA의 한계
DMA 장점: CPU의 반복 데이터 이동 감소, 대용량 I/O에서 CPU 부담 감소, 전송 중 CPU가 다른 명령 수행, 저장장치·네트워크·그래픽 대량 전송에 효과적
DMA 한계: DMA도 메모리·인터커넥트 사용, 대량 DMA면 CPU와 메모리 접근 경쟁, 설정·완료 처리 오버헤드, 아주 작은 전송은 설정 비용이 더 클 수 있음
- DMA는 CPU의 이동 부담을 줄일 뿐, 메모리·인터커넥트 대역폭을 늘려주진 않음
폰 노이만 병목(von Neumann bottleneck): CPU와 메모리 사이 데이터 전달 능력이 제한돼서 전체 성능을 막는 현상. 예: CPU가 빨라도 메모리에서 데이터가 늦게 오면 대기
- 원인: CPU가 명령어와 데이터를 둘 다 메모리에서 가져와 처리하는 구조
- DMA 쓴다고 폰 노이만 병목이 없어지진 않음
구분 DMA 폰 노이만 병목 핵심 문제 CPU의 I/O 데이터 이동 부담 CPU ↔ 메모리 간 전송 성능 제한 주요 대상 I/O 장치 ↔ 메모리 CPU ↔ 메모리 해결·완화 DMA로 직접 데이터 전송 캐시, 메모리 계층, Prefetching 결과 CPU 개입 감소 CPU의 메모리 대기 감소