
- 작성일
CH5. 관계대수 한 장
- Authors

- Name
- seren-wib
Contents
관계대수 한 장 (6장 전부)
SQL은 "뭘 원하는지", 관계대수는 "어떤 순서로 꺼낼지". 답 쓸 땐 ← 로 한 줄씩 끊어 쓰는 게 안 틀림
1. 기호 한눈에
| 기호 | 이름 | 하는 일 | SQL |
|---|---|---|---|
| σ조건(R) | SELECT | 조건 맞는 행 | WHERE |
| π열(R) | PROJECT | 적은 열만, 중복 지움 | SELECT DISTINCT |
| ρS(열…)(R) | RENAME | 테이블·열 이름 바꾸기 | AS |
| R ∪ S, R ∩ S, R − S | 집합 연산 | 합·교·차 | UNION, INTERSECT, EXCEPT |
| R × S | CARTESIAN PRODUCT | 모든 행 조합 | FROM R, S (조건 없이) |
| R ⋈조건 S | JOIN | 조건 맞는 행끼리 붙임 | JOIN ON |
| R * S | NATURAL JOIN | 같은 이름 열로 붙이고 그 열 하나만 | NATURAL JOIN |
| R ⟕ S, R ⟖ S, R ⟗ S | OUTER JOIN | 짝 없어도 남김 | LEFT / RIGHT / FULL OUTER JOIN |
| 그룹열ℱ함수 열(R) | 집계 | 묶어서 COUNT·SUM… | GROUP BY + 집계 |
| R ÷ S | DIVISION | S 전부 가진 R 행 | NOT EXISTS … EXCEPT |
| T ← 식 | 대입 | 중간 결과에 이름 | 임시 테이블 |
2. 행 고르기 σ
σ조건(R): 조건 맞는 행만. 열은 그대로
- 조건은
열 비교 값/열 비교 열, AND·OR·NOT. 비교는 =, <, ≤, >, ≥, ≠
σDno=4(EMPLOYEE) → 4번 부서 직원
σ(Dno=4 AND Salary>25000) OR (Dno=5 AND Salary>30000)(EMPLOYEE)
- σc1(σc2(R)) = σc1 AND c2(R). 순서 상관없음
- 이름이 SELECT인데 SQL의 WHERE임. SQL SELECT 자리는 π
3. 열 고르기 π
π열 목록(R): 적은 열만. 결과는 집합이라 겹치는 행 지움
πLname, Fname, Salary(EMPLOYEE) → 세 열
πSex, Salary(EMPLOYEE) → (M, 25000) 둘이면 하나로
4. 이어 쓰기와 이름 바꾸기 ρ
둘 중 하나: 괄호로 겹치기 / ← 로 끊기. 안쪽(아래 줄)부터 실행
πFname, Lname, Salary(σDno=5(EMPLOYEE))
DEP5_EMPS ← σDno=5(EMPLOYEE)
RESULT ← πFname, Lname, Salary(DEP5_EMPS)
| ρ 쓰는 법 | 바꾸는 것 |
|---|---|
| ρS(B1, B2, …)(R) | 테이블 이름 S, 열 이름 B1, B2… |
| ρS(R) | 테이블 이름만 |
| ρ(B1, B2, …)(R) | 열 이름만 |
| R(B1, B2, …) ← 식 | ← 왼쪽에 열 이름 붙여도 됨 |
R(First_name, Last_name, Salary) ← πFname, Lname, Salary(DEP5_EMPS)
5. 집합 연산 ∪ ∩ −
조건: 열 개수 같고 열마다 타입 같아야 (type compatible)
| 식 | 결과 | 예 |
|---|---|---|
| R ∪ S | 둘 중 하나에라도 있는 행, 중복 지움 | 학생이거나 강사 |
| R ∩ S | 둘 다에 있는 행 | 학생이면서 강사 |
| R − S | R엔 있고 S엔 없는 행. S − R과 다름 | 강사 아닌 학생 |
RESULT1 ← πSsn(DEP5_EMPS)
RESULT2(Ssn) ← πSuper_ssn(DEP5_EMPS)
RESULT ← RESULT1 ∪ RESULT2
- 5번 부서 직원이거나 그 직속 상사인 Ssn. 열 이름 달라서 RESULT2에 (Ssn) 붙임
6. 모든 조합 ×
R × S: R 행 하나마다 S 행 전부 붙임. 열 n + m, 행 |R| × |S|. 타입 안 맞아도 됨
- 혼자선 쓰레기. 뒤에 σ로 짝 맞는 조합만 남김 → 그걸 합친 게 JOIN
FEMALE_EMPS ← σSex='F'(EMPLOYEE)
EMPNAMES ← πFname, Lname, Ssn(FEMALE_EMPS)
EMP_DEPENDENTS ← EMPNAMES × DEPENDENT
ACTUAL_DEPENDENTS ← σSsn=Essn(EMP_DEPENDENTS)
RESULT ← πFname, Lname, Dependent_name(ACTUAL_DEPENDENTS)
- 여직원과 부양가족 이름. 3행 × 7행 = 21행 만들고 σ로 짝 맞는 것만
7. 붙이기 ⋈
R ⋈조건 S = σ조건(R × S). 조건 맞는 R행·S행을 한 줄로
DEPT_MGR ← DEPARTMENT ⋈Mgr_ssn=Ssn EMPLOYEE
RESULT ← πDname, Lname, Fname(DEPT_MGR)
- 부서별 관리자 이름
| 종류 | 조건 | 결과 열 |
|---|---|---|
| THETA JOIN ⋈A θ B | θ는 =, <, ≤, >, ≥, ≠ 아무거나 | R 열 + S 열 전부 |
| EQUIJOIN ⋈A=B | = 만 | R 열 + S 열 전부. 값 같은 열 둘 다 남음 (Mgr_ssn, Ssn) |
| NATURAL JOIN R * S | 이름 같은 열끼리 = | 같은 이름 열은 하나만 |
- NATURAL JOIN은 열 이름이 같아야. 다르면 ρ로 먼저 맞춤
DEPT ← ρ(Dname, Dnum, Mgr_ssn, Mgr_start_date)(DEPARTMENT)
PROJ_DEPT ← PROJECT * DEPT
PROJECT.Dnum과 맞추려고 Dnumber → Dnum
결과 행 수: 0 (하나도 안 맞음) ~ |R| × |S| (전부 맞음)
OUTER JOIN: 짝 없는 행도 남기고 빈 칸 NULL. ⟕ 왼쪽 전부, ⟖ 오른쪽 전부, ⟗ 양쪽
TEMP ← EMPLOYEE ⟕Ssn=Mgr_ssn DEPARTMENT
RESULT ← πFname, Minit, Lname, Dname(TEMP)
- 전 직원 + 관리하는 부서 이름. 관리자 아니면 Dname NULL
8. 세기 ℱ
그룹 열 ℱ 함수 열, …(R): 그룹 열 같은 행끼리 묶어 함수. 함수는 COUNT, SUM, AVERAGE, MAXIMUM, MINIMUM
Dno ℱ COUNT Ssn, AVERAGE Salary(EMPLOYEE) - 부서별 직원 수·평균 급여. 결과 열 Dno, Count_ssn, Average_salary
ℱ COUNT Ssn, AVERAGE Salary(EMPLOYEE)
- 그룹 열 없으면 전체 한 묶음 → 한 행
ρR(Dno, No_of_employees, Average_sal)(Dno ℱ COUNT Ssn, AVERAGE Salary(EMPLOYEE))
열 이름 바꾸려면 ρ로 감쌈
중복 안 지우고 셈 / NULL은 빼고 / 결과는 한 칸이라도 테이블
9. 전부 가진 것 찾기 ÷
R ÷ S: S에 있는 값을 전부 가진 R의 행. S 열은 R 열의 일부여야 하고, 결과 열 = R 열 − S 열
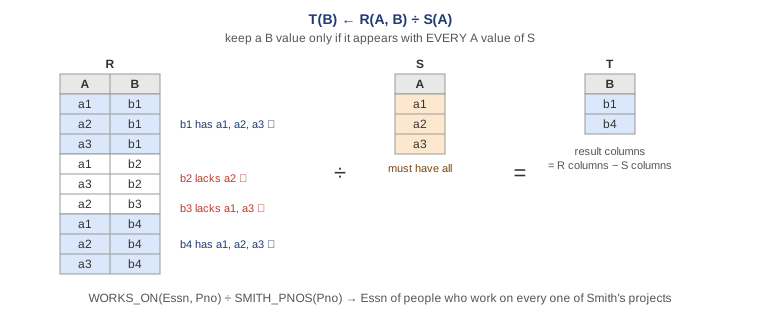
SMITH ← σFname='John' AND Lname='Smith'(EMPLOYEE)
SMITH_PNOS ← πPno(WORKS_ON ⋈Essn=Ssn SMITH)
SSN_PNOS ← πEssn, Pno(WORKS_ON)
SSNS(Ssn) ← SSN_PNOS ÷ SMITH_PNOS
RESULT ← πFname, Lname(SSNS * EMPLOYEE)
- Smith가 하는 프로젝트 전부에 참여하는 직원. SMITH_PNOS = {1, 2}면 1도 2도 하는 Essn만 남음
÷ 쓰는 틀: ① "전부"의 목록 S 만들기(π 한 열) → ② 누가 뭘 하는지 R 만들기(π 두 열, S 열 포함) → ③ R ÷ S → ④ 이름 붙이려고 * 로 원본과 붙이기
10. 완전 집합과 질의 트리
완전 집합 {σ, π, ∪, ρ, −, ×}: 이 여섯으로 나머지 다 만듦
- R ∩ S = (R ∪ S) − ((R − S) ∪ (S − R))
- R ⋈c S = σc(R × S)
질의 트리: 식을 나무로. 잎 = 테이블, 안쪽 = 연산, 잎부터 위로 실행
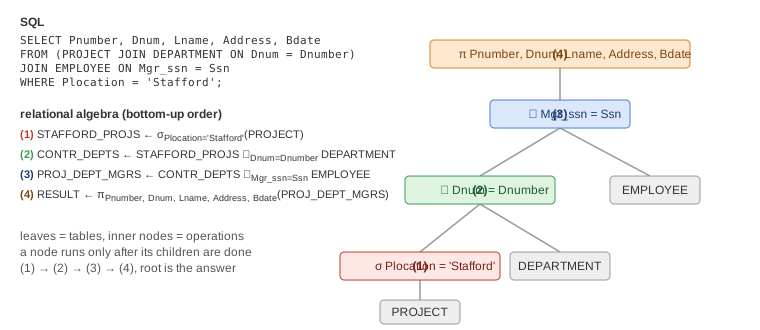
11. 같은 질문, SQL 옆에 관계대수
| 질문 | SQL | 관계대수 |
|---|---|---|
| 5번 부서 직원 이름·급여 | SELECT Fname, Lname, Salary FROM EMPLOYEE WHERE Dno = 5 | πFname, Lname, Salary(σDno=5(EMPLOYEE)) |
| Research 부서 직원 이름·주소 | SELECT Fname, Lname, Address FROM EMPLOYEE, DEPARTMENT WHERE Dname = 'Research' AND Dnumber = Dno | RESEARCH ← σDname='Research'(DEPARTMENT) / RD ← RESEARCH ⋈Dnumber=Dno EMPLOYEE / πFname, Lname, Address(RD) |
| 직원과 상사 이름 | … FROM EMPLOYEE AS E, EMPLOYEE AS S WHERE E.Super_ssn = S.Ssn | S ← ρS(Sssn, Sfn, Sln, …)(EMPLOYEE) / EMPLOYEE ⋈Super_ssn=Sssn S |
| 부서별 직원 수 | SELECT Dno, COUNT(*) FROM EMPLOYEE GROUP BY Dno | Dno ℱ COUNT Ssn(EMPLOYEE) |
| 부양가족 없는 직원 | WHERE NOT EXISTS (SELECT * FROM DEPENDENT WHERE Ssn = Essn) | ALL ← πSsn(EMPLOYEE) / HAS ← πEssn(DEPENDENT) / πFname, Lname((ALL − HAS) * EMPLOYEE) |
| 5번 부서 프로젝트 전부에 참여 | WHERE NOT EXISTS ((SELECT Pnumber FROM PROJECT WHERE Dnum = 5) EXCEPT (SELECT Pno FROM WORKS_ON WHERE Essn = Ssn)) | P5 ← πPnumber(σDnum=5(PROJECT)) / SP ← πEssn, Pno(WORKS_ON) / SP ÷ P5 |
| 상사 없는 직원도 포함해서 직원 + 상사 | LEFT OUTER JOIN | EMPLOYEE ⟕Super_ssn=Sssn S |
12. 문제 문장 → 기호
| 문제에 이 말 나오면 | 쓰는 것 |
|---|---|
| ~인 (조건) | σ |
| ~의 이름, 번호 (열 고르기) | π. 맨 마지막에 |
| 테이블 둘의 열 | ⋈FK=PK. 열 이름 같으면 * |
| 직원과 그 상사 | ρ로 EMPLOYEE 복사본 열 이름 바꾸고 ⋈ |
| ~이거나 | ∪ (열 맞춰서) |
| ~이면서 (두 결과 다에) | ∩ |
| ~가 아닌, ~가 없는 | − (전체 − 있는 것) |
| 몇 명, 합, 평균 | ℱ |
| ~별, ~마다 | ℱ 앞에 그룹 열 |
| 전부에 참여하는, 모든 ~를 | ÷ |
| 짝 없는 것도 보여야 | ⟕ ⟖ ⟗ |
| 열 이름 안 맞아서 * 못 씀 / 결과 열 이름 바꾸기 | ρ |