
- 작성일
CH1. Boolean Retrieval
- Authors

- Name
- seren-wib
Contents
1. Boolean Retrieval
1.1 Introduction
정보검색(IR)이란
- 비정형 자료(DB table = 정형)탐색
- 정보 요구를 만족하는 것을 찾음
- 큰 컬렉션(문서 묶음)에서 찾기
예전에는 돈이 정형쪽에 몰렸는데 요즘은 비정형쪽에 돈이 몰림
불리언 검색 모델(Boolean retrieval)
- IR시스템을 만드는 가장 단순한 모델
- 질의(query)가 불리언 식(ex: Caesar AND Brutus)
- 불리언 식을 만족하는 문서 전부를 순서없이 돌려줌
구글의 방식
- anchor text: 다른 페이지가 이 페이지에 건 링크 글자에 검색어가 있으면, 이 페이지 본문에 그 단어가 없어도 뜬다
- 단어 변형(variant): 동사형태, 철자, 동의어도 같이 뜸
- 긴 쿼리일 때는 단어 몇 개 빠져도 뜨게 함
- 식 결과가 너무 적을 때 조건을 넓혀서 보여줌
- ranking: 단순 불리언은 순서없이 던져주지만 구글은 좋은 결과를 위에 올림 (ch6 6.1에서 계속)
1.2 Inverted index
grep은 안 됨 → 행렬로 해봄 → 행렬이 너무 큼 → 1만 저장하자 = 역색인
grep이 안되는 이유
- 느리다(컬렉션이 크면 처음부터 다 읽어야하기에)
- grep는 줄 단위인데 IR은 문서단위이다
- NOT~ 같은 경우는 문서 전체를 확인해야해서 쉽지 않음
- "Romans 근처에 있는 countryman" 같은 근접 검색은 못한다
단어-문서 결합 행렬(term-document incidence matrix)
- 행은 단어, 열은 문서
- 단어가 문서에 있으면 1, 없으면 0
- 행 하나가 벡터(0/1), 이 벡터끼리 비트연산
| Anthony and Cleopatra | Julius Caesar | The Tempest | Hamlet | Othello | Macbeth | |
|---|---|---|---|---|---|---|
| Anthony | 1 | 1 | 0 | 0 | 0 | 1 |
| Brutus | 1 | 1 | 0 | 1 | 0 | 0 |
| Caesar | 1 | 1 | 0 | 1 | 1 | 1 |
| Calpurnia | 0 | 1 | 0 | 0 | 0 | 0 |
| Cleopatra | 1 | 0 | 0 | 0 | 0 | 0 |
| mercy | 1 | 0 | 1 | 1 | 1 | 1 |
| worser | 1 | 0 | 1 | 1 | 1 | 0 |
- 질의:
Brutus AND Caesar AND NOT Calpurnia/ 자리 하나 = 문서 하나, 같은 자리끼리 AND
                A&C  JC  Tmp  Ham  Oth  Mac
Brutus           1    1   0    1    0    0
Caesar           1    1   0    1    1    1
NOT Calpurnia    1    0   1    1    1    1    (010000 -> 101111)
---------------------------------------------
AND              1    0   0    1    0    0    = 100100
- 결과: Anthony and Cleopatra, Hamlet / Julius Caesar는 Calpurnia가 있어서 탈락
- 컬렉션이 커지면 행렬이 터진다
- token: 중복 포함 나온 단어들
- term: 중복 제외 나온 단어들
- ex: "the the the"이면 token=3, term=1
| 항목 | 값 |
|---|---|
| 문서 수 N | 10⁶ |
| 문서당 token | 약 1000 → 전체 10⁹ token |
| token당 크기 | 6바이트(공백·문장부호 포함) → 컬렉션 약 6GB |
| 서로 다른 term M | 500,000 (= 행 수) |
| 행렬 칸 수 | 500,000 × 10⁶ = 5×10¹¹ |
| 1의 개수 | 최대 10⁹ (token 하나가 1을 많아야 한 칸 만듦) |
- 칸은 5×10¹¹개인데 그 중 1의 개수는 최대 10⁹개여서 거의 다 0이 나온다. 이를 희소(sparse)행렬이라고 부른다. 0 저장하느라 공간을 다 버려서 1만 적자는 결론이 나옴
- 역색인 (Inverted index)
term마다 그 term이 들어 있는 문서 번호(docID) 목록만 저장
Brutus    -> 1 -> 2 -> 4 -> 11 -> 31 -> 45 -> 173 -> 174
Caesar    -> 1 -> 2 -> 4 -> 5 -> 6 -> 16 -> 57 -> 132
Calpurnia -> 2 -> 31 -> 54 -> 101
- term모음(brutus, Caesar, Calpurnia): 사전(dictionary)
- 포스팅(posting): doc ID(ex: 1) 하나
- 포스팅 리스트(postings list): 포스팅 목록(-> 1 -> 2 -> 4 ->...)
- 역색인 만드는 4단계
| 단계 | 하는 일 | 예 |
|---|---|---|
| 1. 문서 수집 | 색인할 문서 모으기 | Friends, Romans, countrymen. So let it be with Caesar… |
| 2. 토큰화(tokenize) | 문서를 token으로 쪼갬 | Friends Romans countrymen |
| 3. 언어 전처리(linguistic preprocessing) | token 정규화 → 색인어(term). 소문자로, 복수형 떼기 | friend roman countryman |
| 4. 색인 | 사전 + 포스팅 만들기 | 아래 6번 |
- 역색인 만들기 예시
- Doc 1: I did enact Julius Caesar: I was killed i' the Capitol; Brutus killed me.
- Doc 2: So let it be with Caesar. The noble Brutus hath told you Caesar was ambitious:
| 단계 | 하는 일 | 결과 |
|---|---|---|
| ① 전처리 | 소문자로, 문장부호 제거 | i did enact julius caesar i was killed … |
| ② (term, docID) 쌍 | 나온 순서대로 | (i,1) (did,1) (enact,1) … (caesar,2) (was,2) (ambitious,2) |
| ③ 정렬 | term 알파벳순, 같으면 docID순 | (ambitious,2) (be,2) (brutus,1) (brutus,2) … |
| ④ 병합 + df | 같은 term끼리 묶어 포스팅 리스트로 | 아래 표 |
| ⑤ 분리 | 사전(term + df) / 포스팅 파일로 나눠 저장 |
| term | df | postings |
|---|---|---|
| brutus | 2 | 1 → 2 |
| caesar | 2 | 1 → 2 |
| i | 1 | 1 |
| was | 2 | 1 → 2 |
- df(document frequency): term이 나온 문서 수 (등장 횟수 X) / caesar는 Doc 2에 2번이어도 df = 2, i는 Doc 1에 2번이어도 df = 1
색인을 크게 만드는 법은 ch4, 압축은 ch5, 순위 검색용 색인은 ch6~7에서.
1.3 Processing Boolean queries
두 단어 AND 질의 처리 순서
- 질의: Brutus AND Calpurnia
- 사전에서 Brutus 찾기
- Brutus 포스팅 리스트 가져오기
- 사전에서 Calpurnia를 찾기
- Calpurnia 포스팅 리스트를 가져와.
- 두 포스팅 리스트를 교집합(intersect)
- 결과 리턴
교집합 알고리즘(Intersect)
Brutus    -> 1 -> 2 -> 4 -> 11 -> 31 -> 45 -> 173 -> 174
Calpurnia -> 2 -> 31 -> 54 -> 101
Answer    => 2 -> 31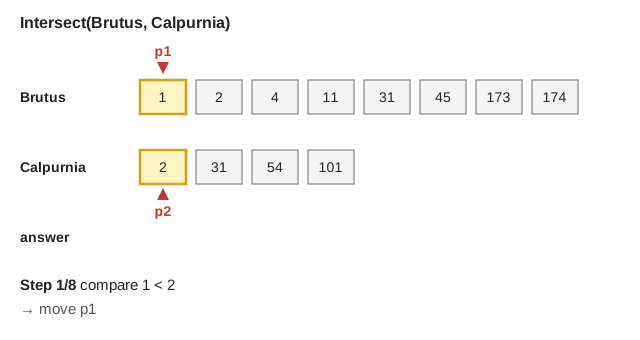
| 단계 | p1 (Brutus) | p2 (Calpurnia) | 비교 | 동작 |
|---|---|---|---|---|
| 1 | 1 | 2 | 1 < 2 | p1 전진 |
| 2 | 2 | 2 | 같음 | 2 추가, 둘 다 전진 |
| 3 | 4 | 31 | 4 < 31 | p1 전진 |
| 4 | 11 | 31 | 11 < 31 | p1 전진 |
| 5 | 31 | 31 | 같음 | 31 추가, 둘 다 전진 |
| 6 | 45 | 54 | 45 < 54 | p1 전진 |
| 7 | 173 | 54 | 173 > 54 | p2 전진 |
| 8 | 173 | 101 | 173 > 101 | p2 전진 → Calpurnia 끝, 종료 |
- 불리언 모델 평가
- AND, OR, NOT으로 이은 불리언 식이면 어떤 질의든 답할 수 있다.
- 문서를 term의 집합으로 본다. 몇 번 나왔는지는 신경 쓰지 않는다.
- 정확(precise)하다. 문서가 조건에 맞거나 안 맞거나 둘 중 하나
- 30년 동안 상업 검색 도구의 주력
- Spotlight, 이메일 검색, 인트라넷 검색도 불리언이다.
- Westlaw(유료 구독자 수 기준 가장 큰 법률 검색 서비스)
- 지금도 불리언 검색이 기본값
| 기호 | 뜻 | 예 |
|---|---|---|
/3 | 3단어 이내 | employment /3 place |
/s | 같은 문장 안 | disclos! /s prevent |
/p | 같은 문단 안 | host! /p guest |
| 공백 | OR (구글은 AND) | responsib! liab! = responsib! OR liab! |
! | 뒤에 뭐가 붙어도 됨 | employe! → employee, employer, employed |
"…" | 구문: 붙어서 그 순서대로 | "trade secret" |
| 정보 요구 | 질의 | 풀어 읽기 |
|---|---|---|
| 취한 손님에 대한 집주인 책임 | host! /p (responsib! liab!) /p (intoxicat! drunk!) /p guest | host, (responsib OR liab), (intoxicat OR drunk), guest가 같은 문단 안 |
| 전 직원의 영업비밀 유출 막는 법리 | "trade secret" /s disclos! /s prevent /s employe! | "trade secret", disclos, prevent, employe가 같은 문장 안 |
| 장애인의 일터 접근 요건 | disab! /p access! /s work-site work-place (employment /3 place) | disab 같은 문단, access 같은 문장 + (work-site OR work-place OR employment 3단어 안 place) |
- 불리언을 선호하는 이유: 정밀도, 투명성, 통제
1.4 Query optimization
AND가 세 개 이상이면 순서가 문제가 된다
- 어떤 연산을 먼저 하는지에 따라서 효율성이 달라진다.
그래서 뭐 먼저 하냐.
- 포스팅 리스트가 짧은 것(df가 작은것) 부터 먼저 AND 연산한다.
최적화된 교집합 알고리즘
- term을 df 오름차순으로 정렬
- 제일 짧은 리스트를 result로 시작, 나머지 term만 남김
- result와 다음 리스트를 1.3 Intersect로 교집합
- term이 남아 있고 result가 안 비었으면 3 반복
- result 반환
- result가 중간에 비면 바로 끝 (뒤에 뭘 AND해도 빈 집합)
- 예: Caesar(2) → Calpurnia(4) → Brutus(8) 순 / Caesar ∩ Calpurnia = 31, ∩ Brutus = 31
Intersect(<t1, ..., tn>)
 1 terms <- SortByIncreasingFrequency(<t1, ..., tn>)
 2 result <- postings(first(terms))
 3 terms <- rest(terms)
 4 while terms != nil and result != nil
 5 do result <- Intersect(result, postings(first(terms)))
 6    terms <- rest(terms)
 7 return result
OR이 섞인 질의
- 모든 term의 df를 구한다
- OR 하나의 크기는 두 df를 더한 값으로 어림잡는다
- 어림잡은 크기가 작은 OR부터 처리한다
- 이 어림잡는 값을 보수적(conservative)이라고 표현한다. 왜냐, OR처리를 하면 두 df를 더한 값이 상한이기 때문에.