
- 작성일
CH2. The Term Vocabulary and Postings Lists
- Authors

- Name
- seren-wib
Contents
2. The term vocabulary and postings lists
2.1 Documents
문서가 뭔지 정의하는건 생각보다 어려운 질문이다
ch1에서는 문서가 뭔지 알고, 읽을 수 있다는 것을 가정하고 넘어갔다.
현실에서는 문서 파싱(parsing a document)이 쉽지 않다.
- 정해야 할 것이 3개 있다.
정할 것 예 형식(format) pdf, word, excel, html 언어(language) 영어, 한국어, 프랑스어 문자 집합(character set) UTF-8, EUC-KR. 같은 바이트도 인코딩 따라 다른 글자 셋 다 분류(classification)문제이다.
대안은 휴리스틱(heuristics)이다.
복잡한 경우(Complications)
- 색인 하나에 여러 언어 term이 섞여 있는 경우
- 문서 하나 안에서도 섞여 있는 경우
- 색인 단위(document unit)을 뭘로 할지
- 결론: 문서가 뭐냐는 질문은 답이 정해진 것이 아닌 설계 결정이다.
2.2 Terms
문서 → token → term으로 바꾸는 과정에서 생기는 문제들
| 용어 | 뜻 | 예 |
|---|---|---|
| word | 텍스트에 나온 그대로의 글자열 | Windows, U.S.A. |
| term | 정규화된 word. 같은 걸로 치는 word 묶음(동치류) | usa (U.S.A., USA) |
| token | 문서에 실제로 한 번 나온 것 하나 | "the the" → token 2개 |
| type | 대부분 term과 같음. 같은 token 묶음 | "the the" → type 1개 |
General + Non-English
정규화(Normalization)
- USA = U.S.A로 보기
언어에 따라 같은 단어도 다른 의미
토큰화(Tokenization): 어떤 token을 내보낼지
- O'Neill → oneill? o'neill? o + neill?
한 단어인지 두 단어인지
- 하이픈에서 끊을지말지, 띄어쓰기 했는데 같은 단어로 볼지
숫자
- 3/20/91, 20/3/91, Mar 20, 1991은 전부 같은 날짜
- 옛날 IR은 숫자를 색인 안했는데 대체로 하는게 유용하다.
띄어쓰기가 없는 언어: 어디서 끊냐?
악센트, 발음 기호
English
대소문자 통일(Case folding): 전부 소문자로 내리기
불용어(Stop words): 너무 흔해서 문서 고르는데 도움 안되는 단어
- and, a, by 같은 것들
- 예전에는 빼는게 표준이었는데 구문 질의에 필요해서 요새는 넣음
다른 동치류: 발음이 같거나 유의어
표제어 추출(Lemmatization)
- 굴절·변형된 꼴 → 사전에 올라가는 기본형(lemma)
- "제대로 된(proper)" 축소
- 굴절(inflectional): 품사는 그대로, 꼴만 바뀜. cutting → cut
- 파생(derivational): 품사까지 바뀜. destruction → destroy
어간 추출(Stemming)
- 단어 끝을 대충 잘라내는 휴리스틱
- 표제어 추출이 언어 지식으로 하려는 걸 대충 흉내냄
- 언어마다 다르고, 굴절이랑 파생 둘 다 자른다
- 예: automate, automatic, automation → 전부 automat. 결과가 사전에 없는 단어여도 상관없다.
Lemmatization Stemming 방식 언어 지식으로 기본형 찾기 끝을 규칙으로 잘라내기 결과 사전에 있는 단어 ( be,car)사전에 없을 수도 ( automat,poni)정확도 높음 대충 예 am, are, is → beautomation → automat포터 알고리즘(Porter algorithm)
- 영어 어간 추출에서 제일 흔한 알고리즘
- 규칙(convention) + 5단계(phase)를 순서대로 적용. 단계마다 명령(command) 여러 개가 있다
- 명령 예: ement로 끝나고 떼고 남는 게 1글자보다 길면 뗌.
replacement → replac/cement → cement(c 한 글자라 안 뗌) - 규칙 예: 복합 명령 안에선 가장 긴 접미사에 맞는 규칙 선택
규칙 예 SSES → SS caresses → caress IES → I ponies → poni SS → SS caress → caress S → (삭제) cats → cat - caresses엔 SSES도 S도 맞지만 더 긴 SSES 선택 → caress (S면 caresse)
스테머 3개 비교 (같은 문장 일부)
원문 Porter Lovins Paice analysis analysi analys analys features featur featur feat easily easili eas easy picture pictur pictur pict interpretation interpret interpres interpret - 스테머마다 결과 다름. Porter가 제일 덜 자름 (Lovins는 the → th, Paice는 picture → pict까지)
어간 추출이 효과를 높이는가?
- 질의에 따라 달라진다.
- good case: [sightseeing tour san francisco] → {tour, tours}
- bad case: [operational AND research] (운영 연구) → porter는 전부 oper로 묶기 때문에 operating, operative도 문서에 걸린다.
- 묶어서 좋은 건 재현율(더 많이 찾기)이고 손해는 정밀도(엉뚱한 것도 찾기)이다.
2.3 Skip pointers
필요한 이유
- ch1의 교집합은 리스트 길이에 선형이다 O(x+y)
- 포스팅 리스트가 수백만개 짜리도 있어서 선형도 느릴 수 있다.
- skip pointer은 결과에 안 들어갈 포스팅을 건너뛰게 해줘서 교집합이 더 빨라진다
- 정할 것 두가지: skip을 어디에 둘지, 건너뛰어도 결과가 틀리지 않게 하려면 어떻게 할지
- 기본아이디어
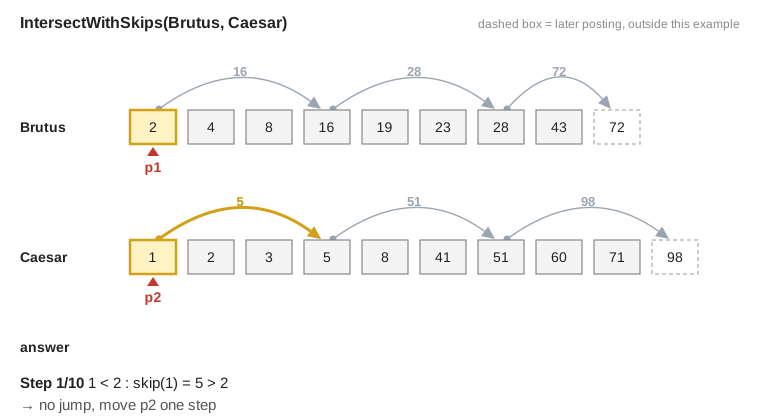
- 그림에서: 회색 화살표 = skip pointer, 노란 화살표 = 확인했지만 안 탐(대상이 상대보다 큼), 초록 화살표 = 탐
- 예: p1이 16, p2가 41 → 16 < 41, skip(16) = 28 ≤ 41 → 28로 점프. 19, 23은 비교도 안 함
- 일부 포스팅에 몇 칸 뒤로 바로 가는 포인터를 하나 더 단다.
- 필수조건: skip이 가리키는 값 ≤ 상대 docID일 때만 점프. 상대보다 큰 데로 점프하면 그 사이에 일치를 놓칠수도 있기 때문에.
알고리즘(IntersectWithSkips)
- 두 docID가 같으면: answer에 추가, 둘 다 한 칸 전진 (ch1과 같음)
- 다르면 작은 쪽을 옮김
- 작은 쪽에 skip이 있고 skip 대상 ≤ 상대 docID면: 조건이 맞는 동안 skip을 계속 탐 (while, 여러 번 연속 가능)
- 아니면: 한 칸만 전진 (ch1과 같음)
- 한쪽이 끝나면 answer 반환
<가 아니라<=: 같은 값으로 점프하면 그게 일치라서 손해 없음
IntersectWithSkips(p1, p2)
 1 answer <- < >
 2 while p1 != nil and p2 != nil
 3 do if docID(p1) = docID(p2)
 4      then Add(answer, docID(p1))
 5           p1 <- next(p1)
 6           p2 <- next(p2)
 7      else if docID(p1) < docID(p2)
 8           then if hasSkip(p1) and (docID(skip(p1)) <= docID(p2))
 9                  then while hasSkip(p1) and (docID(skip(p1)) <= docID(p2))
10                       do p1 <- skip(p1)
11                  else p1 <- next(p1)
12           else if hasSkip(p2) and (docID(skip(p2)) <= docID(p1))
13                  then while hasSkip(p2) and (docID(skip(p2)) <= docID(p1))
14                       do p2 <- skip(p2)
15                  else p2 <- next(p2)
16 return answer
skip를 어디에 둘지
skip 하나가 건너뛰는 양 쓸 수 있는 빈도 skip 많이 (간격 좁게) 조금 자주. 대신 비교 횟수·저장 공간 늘어남 skip 적게 (간격 넓게) 많이 드물게. 대상이 상대보다 커서 못 쓰는 경우 많음 - 휴리스틱: 길이 P 리스트에 √P개를 같은 간격으로. P = 16 → 4개, 4칸마다
- 질의 term 분포는 무시함
- 정적 색인이면 쉬움, 동적(문서 추가·삭제)이면 skip을 다시 놔야 해서 어려움
예전엔 도움 많이 됐는데, 요샌 CPU가 좋아서 크게 도움 안됨.
2.4 Phrase queries
구문질의(phrase queries)가 뭐고 왜 필요한지
- [stanford university]는 두 단어가 붙어서, 그 순서대로 나와야 할 때
- "The inventor Stanford Ovshinsky never went to university"는 둘 다 있지만 맞으면 안된다.
- 웹 질의 중 상당수가 구문 질의.
- 결론: 포스팅에 docID만 있으면 부족하다.
- 해결책: biword 색인, positional 색인.
Biword 색인
- 붙어 있는 두 단어 쌍을 term 하나로 색인한다.
- 예: Friends, Romans, Countrymen →
friends romans,romans countrymen - 두 단어 구문은 바로 답할 수 있다.
- 긴 구문:
"stanford university palo alto"→"stanford university" AND "university palo" AND "palo alto"- 셋 다 있어도 네 단어가 이어져 있다는 보장 없음 → false positive → 결과를 다시 걸러야 함(post-filtering)
- 잘 안 쓰이는 이유: false positive, 사전 폭발(index blowup)
Positional 색인
- biword보다 효율적인 대안
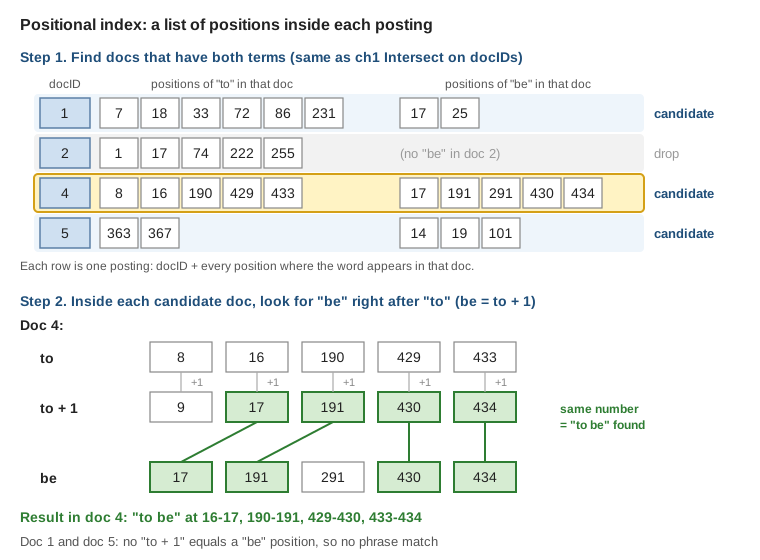
- 그림에서: 위 표 = 1단계(docID 교집합, 행 하나가 포스팅 하나), 아래 = 2단계(4번 문서 안에서 to 위치 + 1 = be 위치 찾기)
포스팅 하나 보통 색인 docID positional 색인 docID + 그 문서 안에서 나온 위치 목록 to, 993427: 1: <7, 18, 33, 72, 86, 231> 2: <1, 17, 74, 222, 255> 4: <8, 16, 190, 429, 433> 5: <363, 367> be, 178239: 1: <17, 25> 4: <17, 191, 291, 430, 434> 5: <14, 19, 101>to, 993427: 993427 = df /4: <8, 16, ...>= 4번 문서의 8번째, 16번째 단어가 to- 질의
"to be or not to be"처리- docID 교집합 (ch1과 같음) → 둘 다 있는 문서가 후보
- 후보 문서 안에서 위치 비교: to가 i면 be는 i+1
- 4번 문서: to 429, be 430, to 433, be 434 → 429부터 to be or not to be → match
근접 검색(Proximity search)
- positional 색인이 있으면 Westlaw의
/k도 가능 employment /4 place: 두 단어가 4단어 이내- "Employment agencies that place healthcare workers ..." → hit (1번째, 4번째: 거리 3)
- "Employment agencies that have learned to adapt now place ..." → hit 아님 (1번째, 9번째: 거리 8)
- 단순한 방법은 두 단어 위치를 모든 쌍으로 비교(cross-product) → the 같은 흔한 단어면 너무 느림
- 문서 목록만이 아니라 맞은 위치까지 돌려줘야 한다 (검색 결과 요약 문장 만들 때 씀)
- positional 색인이 있으면 Westlaw의
PositionalIntersect(p1, p2, k)
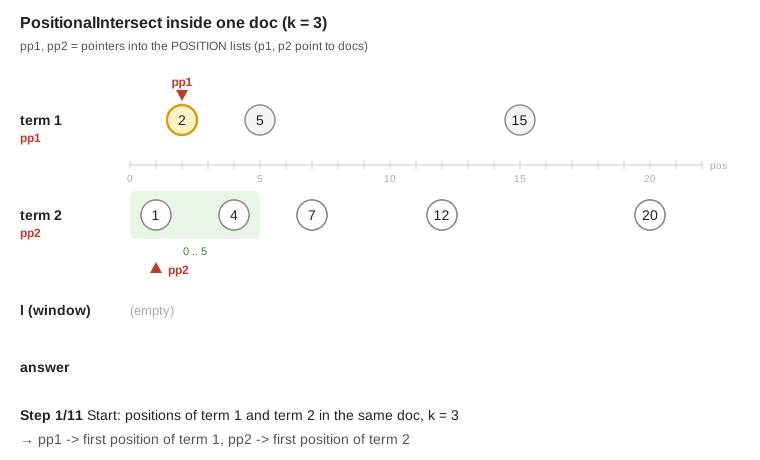
- p1, p2 = 문서(docID) 가리키는 포인터 / pp1, pp2 = 그 문서 안의 위치 목록 가리키는 포인터
- 그림에서: 초록 띠 = pp1 위치 ± k 범위, l = 띠 안에 들어온 term 2 위치들, answer = (term 1 위치, term 2 위치) 쌍
- 바깥은 ch1 Intersect 그대로, 같은 문서를 찾으면 안에서 위치끼리 비교
- l = 지금 pp1 위치에서 k 이내인 pp2 위치 목록 (창문처럼 씀)
- pp2를 밀면서 k 이내면 l에 넣고, pp1보다 너무 뒤로 가면 멈춤
- pp1이 앞으로 가면 k보다 멀어진 l 앞쪽 값을 버림
- l에 남은 것마다 (docID, pp1 위치, pp2 위치)를 answer에 추가
Combination scheme
- biword + positional 섞어 쓰기
- 아주 자주 나오는 biword(Michael Jackson, Britney Spears)만 term으로 색인 → 위치 비교 없이 바로 답해서 빠름
- 나머지 구문은 positional 교집합
- Williams et al. (2004): positional보다 빠르고 공간은 26% 더 씀
구글에서 positional 질의는 비싸다
- 포스팅마다 위치 목록까지 읽어야 하고, docID 교집합 뒤에 위치 비교를 한 번 더 해야 해서