
- 작성일
CH3. Dictionaries and Tolerant Retrieval
- Authors

- Name
- seren-wib
Contents
3. Dictionaries and tolerant retrieval
3.1 Dictionaries
지금까지 포스팅 쪽만 팠다면 이 챕터는 사전 쪽을 다룬다.
질의 단어가 들어왔을 때 사전에서 그 단어를 어떻게 빨리 찾나?
사전이 뭔지
- term vocabulary(용어 어휘): 데이터 그 자체. "어떤 단어들이 있냐"(vocabulary = term의 집합, term = 단어 하나(중복없는))
- dictionary(사전): 그 어휘를 저장하는 자료구조
고정 길이 배열로 저장
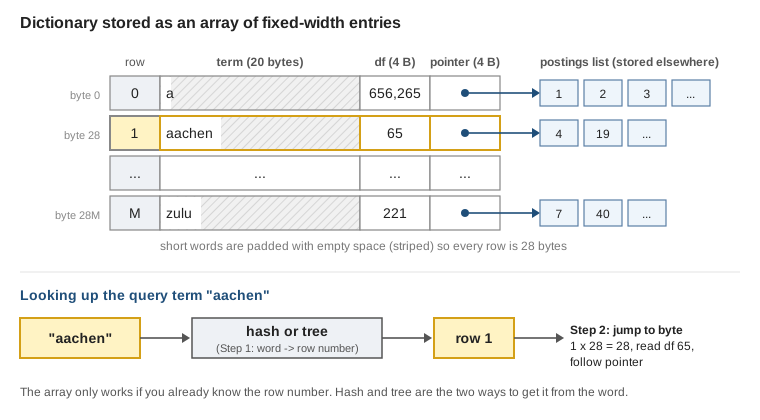
- 사전 = 줄(term 하나)을 늘어놓은 배열. 모든 줄 크기가 똑같음
- 한 줄 = term(20바이트) + df(4바이트) + 포스팅 리스트 포인터(4바이트) = 28바이트, 한 줄에는 term 하나
- df: 짧은 리스트부터 AND할 때 씀(ch1 1.4) / 포인터: 따로 저장된 포스팅 리스트 위치
- 짧은 단어는 빈칸으로 채워서 20바이트를 다 씀 (
a도 20바이트) → 낭비, ch5 압축에서 다룸 - 고정하는 이유: n번째 줄 시작 = n × 28바이트 → 줄 번호만 알면 바로 감
- 문제: 질의는 줄 번호가 아니라 단어로 들어옴 → 단어 → 줄 번호를 찾는 장치 필요
- 그 장치가 해시 or 트리 (사전 자료구조 두 종류). 고정 길이 배열은 둘 다 밑에 깔린 저장 방식이지 세 번째 선택지가 아님
- 그림에서: 위 = 배열(줄무늬 = 빈칸 채운 부분), 아래 = "aachen" → 해시 or 트리 → row 1 → 28바이트 위치로 점프
질의 단어로 배열의 row 찾는 방법
- hash or tree
- IR 시스템마다 다름. 고르는 기준:
기준 해시 쪽 트리 쪽 term 수가 고정? 계속 늘어남? 고정 계속 늘어남 (해시는 rehash 필요) 키마다 조회 빈도 정확한 단어 조회 위주 접두사·범위 조회도 필요 term이 몇 개쯤? 규모가 예측됨 규모 예측 어려움 해시(Hashes)
- 각 term을 정수로 해싱, 이 때 나오는 정수가 배열의 row번호
- 그러니까 단어를 해싱하면 바로 그 줄로 감
- 장점: 트리보다 빠르다. 이건 O(1)
- 단점
- 비슷한 변형을 못찾는다(resume vs résumé), 해시 값이 완전히 달라짐
- 접두사 검색 불가(automat으로 시작하는 term 전부 찾기. ch2 stemming 예시 automate, automatic, automation → automat의 그 automat), 따라서 와일드 카드 불가
- 어휘가 계속 늘어나서 배열이 꽉 차면(꽉 차기 전에도 충돌 문제가 발생) 배열을 더 크게 바꿔야 하는데, 이러면 줄번호가 전부 바뀌기 때문에 전부 다시 해싱(rehash)해야함
트리(Trees) 접두사 문제 해결 가능
- 이진 트리(binary tree)로 하면 제일 간단함
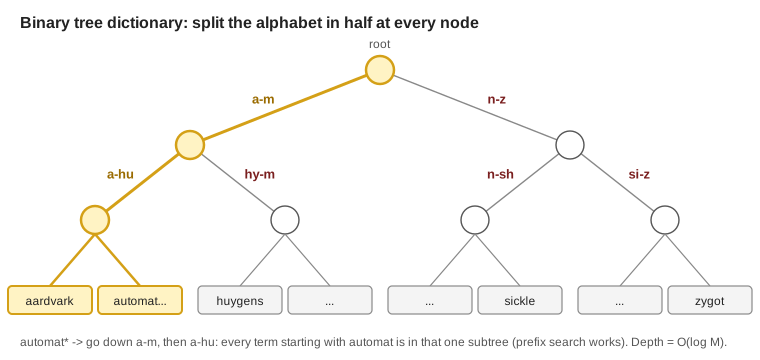
노드마다 알파벳 범위를 반으로 나눔: a-m / n-z → a-hu / hy-m ... → 잎(leaf)에 실제 term
그림에서: automat* → a-m → a-hu로 내려가면 automat으로 시작하는 term이 그 아래에 다 모여 있음 = 접두사 검색
검색은 해시보다 조금 느리다. O(log M), M = 어휘 크기
- 근데 O(log M)은 균형 잡힌(balanced) 트리일 때만 성립
- 이진 트리는 다시 균형 맞추는(rebalancing) 비용이 크다
해결책: B-tree
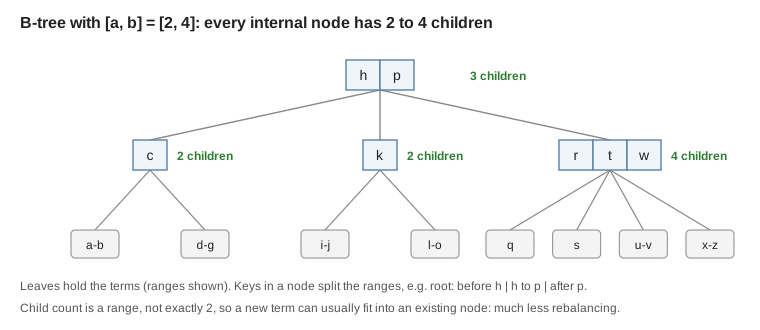
- 정의: 모든 내부 노드의 자식 수가 [a, b] 구간 안. 예: [2, 4]
- 그림에서: 루트 자식 3개, 그 아래 2개, 2개, 4개 → 전부 2~4 안
- 자식 수가 딱 2가 아니라 범위라서, 새 term이 들어와도 기존 노드 안에서 흡수 → 재균형이 훨씬 덜 일어남
- 노드 안 키(h, p)가 범위를 나눔: h 앞 / h~p / p 뒤
해시 vs 트리 한 줄 비교
해시 트리 (B-tree) 조회 속도 O(1), 더 빠름 O(log M), 조금 느림 접두사 검색 (automat*) X O 변형 찾기 (resume / résumé) X 근처라서 찾기 쉬움 어휘가 늘면 전부 rehash 균형 맞추기 (B-tree는 덜 비쌈)
3.2 Wildcard queries
mon*에 맞는 term들(monday, month, money)을 사전에서 어떻게 빨리 찾냐
wildcard 질의 → 맞는 term 집합 → 그 term 중 하나라도 들어간 문서(OR)
wildcard 질의: *가 아무 글자열이나 대신하는 질의. 예: mon* = mon으로 시작하는 term이 들어간 문서 전부
*가 끝에 있을 때 (mon*)- B-tree에서 범위 검색:
mon ≤ t < moo인 term t 전부 탐색 - 3.1에서 트리는 접두사 검색이 된다고 한 게 이거
- B-tree에서 범위 검색:
*가 앞에 있을 때 (*mon)- term을 거꾸로 뒤집어 저장한 B-tree를 하나 더 둠 (lemon → nomel)
- 거꾸로 트리에서
nom ≤ t < non범위 검색
처리 순서
- wildcard 질의 → 맞는 term 집합 → 그 term 중 하나라도 들어간 문서
*가 가운데 있을 때 (m*nchen)m*결과와*nchen결과를 각각 찾아서 교집합 → 되긴 하는데 비쌈- 대안: permuterm index
Permuterm index
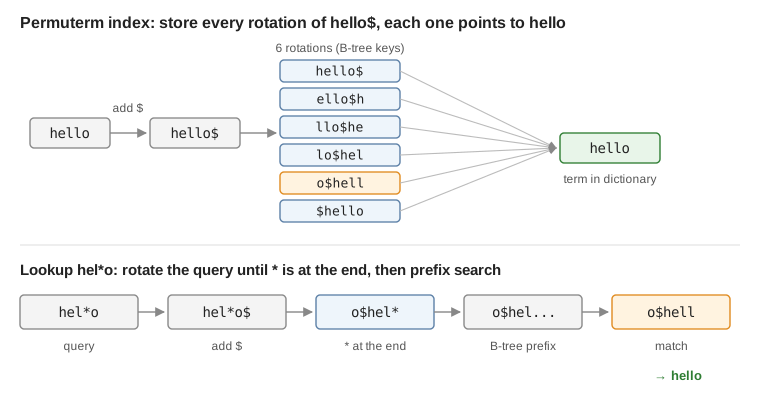
- term 끝에
$붙이고, 돌린(rotate) 결과를 전부 B-tree에 넣음. 전부 원래 term을 가리킴 - 왜 *을 끝으로 돌리냐: *이 끝에 있어야 쿼리가 가능하기 때문에.
- $ 기준으로 왼쪽이 끝, 오른쪽이 시작
- hello → hello$, ello$h, llo$he, lo$hel, o$hell, $hello (6개)
- 질의도 돌려서
*를 맨 끝으로 보냄 → 그다음은 1번처럼 접두사 검색 - 그림에서: 위 = 회전 6개가 전부 hello로 연결 / 아래 = hel*o → o$hel* → o$hel로 시작하는 키 o$hell → hello
질의 찾는 키 XX$X*$X**XX$**X*X*X*YY$X*- 예:
hel*o→o$hel* - 이름은 index인데 실제론 트리 (permuterm tree가 더 맞는 이름)
- 단점: 사전 크기가 일반 B-tree의 4배 넘게 커짐 (실험값)
- term 끝에
k-gram index
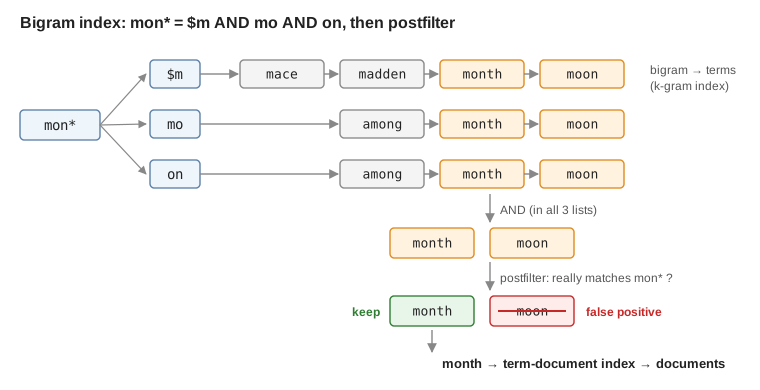
- k-gram: term 안의 연속된 글자 k개. 2-gram = bigram
$= 단어 경계. 예: april →$a ap pr ri il l$- k-gram → 그 k-gram이 들어간 term 목록을 역색인으로 저장. 예 (3-gram): etr → beetroot, metric, petrify, retrieval
- 역색인이 두 종류가 됨: term → 문서 (원래 것) / k-gram → term (이것)
mon*처리:$m AND mo AND on→ mon으로 시작하는 term + moon 같은 거짓 양성(false positive)- 그래서 후처리(postfilter): 나온 term을 원래 질의랑 다시 대조 → 남은 term만 term-문서 역색인에서 찾음
- 그림에서: 세 리스트에 다 있는 month, moon → 후처리에서 moon 탈락 → month만 문서 검색
k-gram vs permuterm
k-gram permuterm 공간 덜 씀 4배 넘게 후처리 필요 필요 없음 구글이 wildcard를 제대로 지원 안 하는 이유
- 문제 1: wildcard 하나가 term 여러 개로 펼쳐짐 → 불리언 질의를 엄청 많이 돌려야 함.
[gen* universit*]= (geneva OR genève OR general ...) AND (university OR université ...) → OR 묶음들의 AND, 너무 비쌈 - 문제 2: 사용자는 타이핑을 싫어함 →
[pyth* theo*]같은 줄임 질의를 허용하면 엄청 많이 씀 → 비용 크게 늘어남 - 구글 Suggest(자동완성)로 어느 정도 완화
- 문제 1: wildcard 하나가 term 여러 개로 펼쳐짐 → 불리언 질의를 엄청 많이 돌려야 함.
3.3 Edit distance
오타 난 질의어가 사전 term이랑 얼마나 다른지 숫자로 재는 법 (3.4 철자 교정에서 씀)
Edit distance (편집 거리)
- s1을 s2로 바꾸는 데 드는 기본 연산의 최소 횟수. 예: dog → do = 1 (g 삭제)
- Levenshtein distance: 연산 = insert, delete, replace (전부 비용 1)
- 예: dog-do 1 / cat-cart 1 (r insert) / cat-cut 1 (a→u replace) / cat-act 2
- Damerau-Levenshtein: 위 3개 + transposition(붙어 있는 두 글자 자리 바꾸기). cat-act = 1 (ca → ac 한 번)
계산: 표(matrix) 채우기
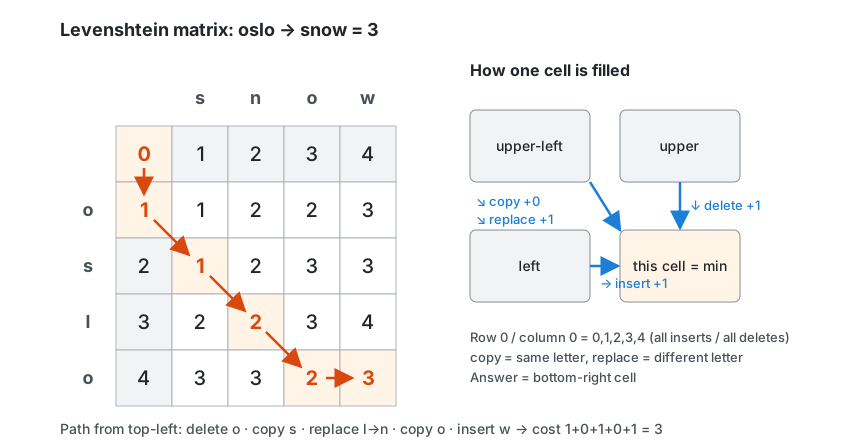
- 행 = s1 글자, 열 = s2 글자. m[i, j] = s1 앞 i글자 → s2 앞 j글자의 거리
- 0행 = 0, 1, 2, ... (빈 문자열에서 j글자 만들기 = insert j번) / 0열 = 0, 1, 2, ... (i글자 다 지우기 = delete i번)
- 칸 하나 = 세 방향 중 최소
- ↘ 왼쪽 위 + 0 (두 글자 같음, copy) / + 1 (다름, replace)
- ↓ 위 + 1 (delete)
- → 왼쪽 + 1 (insert)
- 답 = 오른쪽 아래 칸
- 그림에서: 오른쪽 = 칸 하나 채우는 규칙 / 왼쪽 = oslo → snow 표, 주황 경로 따라 읽으면 delete o, copy s, replace l→n, copy o, insert w = 3
예: cats → fast = 3
f a s t 0 1 2 3 4 c 1 1 2 3 4 a 2 2 1 2 3 t 3 3 2 2 2 s 4 4 3 2 3 - c→f replace(1), a copy(0), t→s replace(1), s→t replace(1) = 3. Levenshtein엔 transposition이 없어서 ts → st도 2
- 슬라이드 표는 칸 하나를 넷으로 나눠서 씀: 왼쪽 위 = ↘ 값, 오른쪽 위 = ↓ 값, 왼쪽 아래 = → 값, 오른쪽 아래 = 셋 중 최소
- 연산 순서는 오른쪽 아래 칸에서 거꾸로 올라가며 읽음(어느 방향에서 최소가 왔는지 따라감)
동적 계획법(dynamic programming)인 이유
- 최적 부분 구조(optimal substructure): 전체 최적해 안에 부분 문제의 최적해가 들어 있음. 부분 문제 = 두 접두사의 edit distance
- 겹치는 부분 문제(overlapping subsolutions): 같은 접두사 거리를 3번씩 씀(→, ↘, ↓) → 표에 저장해두고 다시 안 계산함
Weighted edit distance
- 연산 비용이 어떤 글자냐에 따라 다름. 키보드 오타 반영: m은 q보다 n으로 잘못 침 → m→n replace가 m→q보다 쌈
- 입력으로 가중치 행렬(weight matrix) 필요, 표 채울 때 +1 대신 가중치를 더함
철자 교정에 쓰는 법
- 질의어에서 정해둔 (가중치) edit distance 안에 드는 글자열 전부 나열
- 그걸 "맞는 단어" 목록과 교집합
- 교집합에 남은 term을 사용자에게 제안
연습문제
- oslo → snow = 3 (그림)
- cat → catcat = 3: copy c, a, t + insert c, a, t
3.4 Spelling correction
오타 난 질의어를 맞는 단어로 고치는 법
어디에 쓰나
- 색인할 문서 교정 / 사용자 질의 교정
방법 2가지
- isolated word: 단어 하나씩 따로 보고 오타 판단. 오타가 다른 맞는 단어가 되면 못 잡음. 예: an asteroid that fell form the sky (form도 맞는 단어)
- context-sensitive: 주변 단어까지 봄 → 위의 form/from 잡음
문서 교정
- MS Word 같은 대화형 교정은 수업 범위 X
- IR에선 주로 OCR(광학 문자 인식)한 문서에 씀
- 기본 원칙: 문서는 안 고침
질의 교정: isolated word
- 전제 1: 맞는 철자를 꺼낼 "맞는 단어" 목록이 있음
- 전제 2: 오타와 맞는 단어 사이 거리를 잴 수 있음
- 알고리즘: 오타와 거리가 제일 가까운 맞는 단어 반환. 예: informaton → information
- 맞는 단어 목록 후보
- 컬렉션의 term vocabulary (문제: 컬렉션 문서에도 오타가 있어서 오타가 "맞는 단어"로 들어감)
- 표준 사전(Webster's, OED) / 업계 전용 사전(전문 IR 시스템용) / 가중치 준 컬렉션 term vocabulary
- 거리 재는 법: edit distance(Levenshtein), weighted edit distance, k-gram overlap
k-gram index로 교정
- 질의어의 k-gram 전부 나열. 예: bordroom의 bigram = bo, or, rd, dr, ro, oo, om
- k-gram index에서 그 k-gram이 들어간 "맞는" term들을 가져옴
- 겹치는 k-gram 수로 거름(threshold). 예: k-gram이 최대 3개까지 다른 term만
bigram term 목록 bo aboard, about, boardroom, border or border, lord, morbid, sordid rd aboard, ardent, boardroom, border Context-sensitive: hit-based
- 예: flew form munich
- 단어마다 가까운 맞는 term 찾음: flew → flea, form → from, munich → munch
- 한 번에 한 단어만 바꾼 구절을 전부 질의로 돌림
질의 바꾼 단어 flea form munich flew → flea flew from munich form → from flew form munch munich → munch - hit(검색 결과 수)가 제일 많은 구절이 정답 → flew from munich
- 후보 수: flew 7개, form 20개, munich 3개면 한 번에 하나씩 = 7 + 20 + 3 = 30 / 전부 조합 = 7 × 20 × 3 = 420
- 단점: 비효율 → 문서 대신 질의 모음(collection of queries)을 봄
일반 문제
- UI: 자동 교정 vs 제안 / "Did you mean"은 제안 하나일 때만 됨, 여러 개면? / 단순한 UI vs 강력한 UI 트레이드오프
- 비용: 교정은 비쌀 수 있음 → 모든 질의에 돌리지 말고 결과 문서가 적은 질의에만? / 대형 검색엔진은 모든 질의에 돌려도 될 만큼 효율적일 거라고 추측
연습: Peter Norvig 교정기
- NWORDS: big.txt 단어별 빈도 (처음 본 단어도 1)
edits1(word): 한 번 편집한 글자열 전부 = delete, transpose, replace, insert (Damerau-Levenshtein 거리 1)known_edits2(word): 두 번 편집한 것 중 NWORDS에 있는 것correct(word): 후보 = 단어 자체가 사전에 있으면 그거 → 없으면 거리 1 → 거리 2 → 그래도 없으면 원래 단어. 후보 중 빈도 제일 높은 거 반환
3.5 Soundex
철자는 달라도 발음이 비슷한 term을 찾는 법
Soundex
- 발음(phonetic) 기준으로 비슷한 term 찾기. 철자(orthographic) 기준인 3.3·3.4와 다름. 예: chebyshev / tchebyscheff
- 방법: 색인할 token을 전부 4글자 축약형으로 바꿈 → 질의 term도 똑같이 바꿈 → 축약형으로 색인 만들고 검색
알고리즘
첫 글자는 그대로 둠
A, E, I, O, U, H, W, Y →
0나머지 글자 → 숫자
글자 숫자 B, F, P, V 1 C, G, J, K, Q, S, X, Z 2 D, T 3 L 4 M, N 5 R 6 같은 숫자가 연속이면 하나만 남김 (반복)
0전부 지움 → 뒤에0붙여서 채우고 앞 4자리 반환 = 글자 1개 + 숫자 3개
예: HERMAN → H655
단계 결과 1. 첫 글자 H 2·3. ERMAN 변환 065054. 연속 중복 06505(없음)5. 0 지우기 655반환 H655 - HERMANN도 H655:
065055→ 4단계에서55→5 - 짧으면 0으로 채움: LEE →
00→0→ 지우면 없음 → L000
- HERMANN도 H655:
얼마나 쓸모 있나
- IR에선 별로
- 놓치면 안 되는 high recall 작업엔 괜찮음 (예: 인터폴)
- IR용 더 나은 발음 매칭: Zobel and Dart (1996)
ch3 정리 (take-away)
- tolerant retrieval: 질의 term과 문서 term이 정확히 안 맞을 때 어떻게 하냐
- wildcard 질의(3.2) / 철자 교정(3.3·3.4) / 발음 매칭(3.5)