
- 작성일
CH4. Index Construction
- Authors

- Name
- seren-wib
Contents
4. Index construction
4.1 Introduction
아주 큰 컬렉션으로 역색인을 어떻게 만드냐 → 그 전에 하드웨어 제약부터
하드웨어 기초
- IR 설계 결정 상당수가 하드웨어 제약 때문에 정해짐
- 메모리 접근이 디스크보다 훨씬 빠름 (대략 10배)
- 디스크 탐색(seek) = 노는 시간: 디스크 헤드가 위치 잡는 동안엔 데이터 전송 0
- seek 한 번(5 ms) = 바이트 25만 개 전송 시간 → seek이 압도적으로 비쌈
- 큰 덩어리 한 번 > 작은 덩어리 여러 번: 디스크 → 메모리 전송은 seek 횟수를 줄여야 빠름
- 디스크 I/O는 블록 단위: 작은 조각이 아니라 블록 통째로 읽고 씀. 블록 크기 8KB ~ 256KB
- IR 서버: 메모리 수 GB, 디스크 수 TB
- 결함 허용(fault tolerance)은 비쌈 → 고장 안 나는 비싼 기계 1대보다 평범한 기계 여러 대가 쌈 (4.4 분산 색인으로 이어짐)
RCV1 컬렉션
- 셰익스피어 전집은 너무 작음 → 확장 가능한(scalable) 색인 구성 예시로 Reuters RCV1 사용
- 1995~1996년(1년치) 영어 뉴스 기사. 예: "Extreme conditions create rare Antarctic clouds"
기호 항목 값 N 문서 수 800,000 L 문서당 token 수 200 M term 수 (= word type) 400,000 token당 바이트 (공백·구두점 포함) 6 token당 바이트 (빼고) 4.5 term당 바이트 7.5 T non-positional 포스팅 수 100,000,000 - 연습: term 하나가 평균 몇 번 나오나 = 전체 token 수 N × L = 160,000,000 / M 400,000 = 400번
- 연습: token 4.5바이트 vs term 7.5바이트 차이 = 자주 나오는 단어(the, of, a)는 짧음. token 평균은 짧은 단어가 수없이 세어지고, term 평균은 단어마다 한 번만 세어짐
- 연습: positional 포스팅 수 = 위치마다 하나 = token 수 = 160,000,000
연습: 이 알고리즘은 왜 아주 큰 컬렉션에서 안 되나
4.2 BSBI algorithm
메모리에 다 안 들어가는 포스팅을 디스크 써서 정렬하는 법
목표: 역색인 만들기
- dictionary(term) → postings(docID 리스트). 예: Brutus → 1 2 4 11 31 45 173 174
ch1 방식: 메모리에서 정렬
- 문서 파싱하면서 (term, docID) 쌍을 나열 → term 순(같으면 docID 순)으로 정렬 → 같은 term끼리 묶어서 포스팅 리스트
- 예: Doc 1
I did enact julius caesar ..., Doc 2so let it be with caesar ...→ 정렬 후 ambitious 2, be 2, brutus 1, brutus 2, capitol 1, caesar 1, caesar 2, ...
큰 컬렉션에서 안 되는 이유
- 문서를 하나씩 파싱함 → 어떤 term의 포스팅도 마지막 문서까지 가야 완성
- 포스팅 전부 메모리에 두고 마지막에 정렬? 큰 컬렉션은 안 됨 → 중간 결과를 디스크에 저장해야 함
- 같은 알고리즘을 디스크에서 돌리면? 안 됨. 디스크에서 정렬하면 seek이 너무 많아서 느림 → 외부 정렬(external sorting) 필요
외부 정렬 (RCV1)
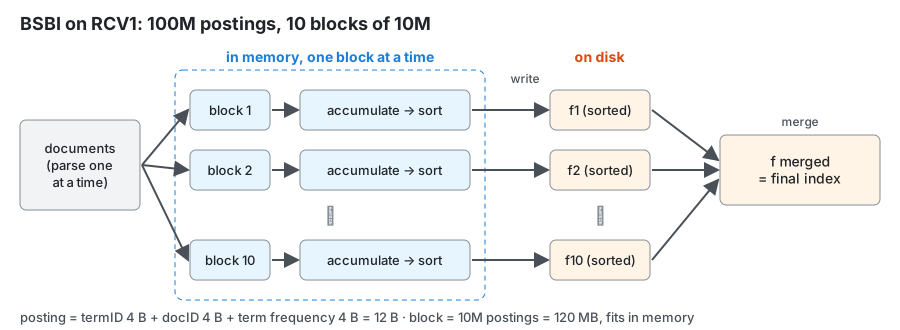
- 정렬할 것: T = 1억 개 non-positional 포스팅
- 포스팅 하나 = 12바이트: termID 4 + docID 4 + term 빈도 4
- 블록 = 포스팅 1천만 개 (120MB, 메모리에 쉽게 들어감) → RCV1은 블록 10개
- 블록마다: (i) 포스팅 모으기 (ii) 메모리에서 정렬 (iii) 디스크에 씀
- 마지막에 블록들을 병합(merge)해서 하나의 긴 정렬 결과로
- 그림에서: 파란 점선 = 메모리 (한 번에 블록 하나), 주황 = 디스크 파일 f1 ~ f10 → 병합 → 최종 색인
두 블록 병합
각 블록은 이미 정렬돼 있음 → 두 블록 맨 앞끼리 비교해서 작은 것부터 꺼냄 (ch1 교집합처럼 포인터 두 개)
블록 그대로: Block 1 = brutus d3, caesar d4, noble d3, with d4 / Block 2 = brutus d2, caesar d1, julius d1, killed d2
비교 기준: term 먼저(알파벳 순), term이 같으면 docID 작은 쪽
단계 Block 1 맨 앞 Block 2 맨 앞 꺼내는 것 1 brutus d3 brutus d2 brutus d2 2 brutus d3 caesar d1 brutus d3 3 caesar d4 caesar d1 caesar d1 4 caesar d4 julius d1 caesar d4 5 noble d3 julius d1 julius d1 6 noble d3 killed d2 killed d2 7 noble d3 (끝) noble d3 8 with d4 (끝) with d4 - 병합 결과 = 꺼낸 순서: brutus d2, brutus d3, caesar d1, caesar d4, julius d1, killed d2, noble d3, with d4
알고리즘
BSBIndexConstruction() n = 0 while (all documents have not been processed) n = n + 1 block = ParseNextBlock() BSBI-Invert(block) WriteBlockToDisk(block, f_n) MergeBlocks(f_1, ..., f_n; f_merged)- ParseNextBlock: 문서를 읽어서 블록 하나 분량의 (termID, docID) 쌍을 모음
- BSBI-Invert: 블록을 메모리에서 정렬하고 같은 termID끼리 포스팅 리스트로 묶음
- WriteBlockToDisk: 그 블록 결과를 디스크 파일 f_n으로 씀
- MergeBlocks: f_1 ~ f_n을 병합해서 최종 색인 f_merged
4.3 SPIMI algorithm
BSBI의 term→termID 사전 문제를 없애고, 정렬도 안 하는 방법
BSBI(정렬 기반)의 문제
- 가정: 사전을 메모리에 계속 둘 수 있다 → term → termID 바꾸려면 사전이 필요한데, 사전은 계속 커짐
- termID 대신 (term, docID) 포스팅으로 하면? → 중간 파일이 엄청 커짐 → 확장은 되지만 아주 느림
SPIMI (Single-pass in-memory indexing)
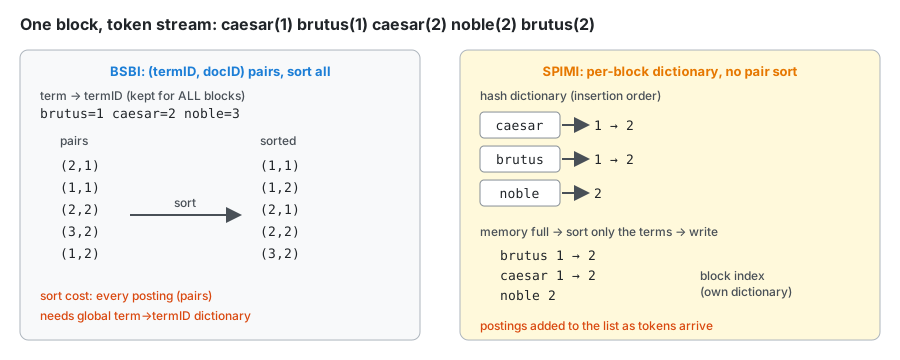
- 핵심 1: 블록마다 따로 사전을 만듦 → 블록끼리 term-termID 대응을 유지할 필요 없음
- 핵심 2: 정렬 안 함. token이 나오는 대로 그 term의 포스팅 리스트에 바로 붙임
- 두 개 합치면 블록마다 완전한 역색인이 하나씩 나옴 → 이걸 병합해서 큰 색인 하나로
- 그림에서: 왼쪽 BSBI = termID 쌍 전부 정렬 + 전체 블록용 사전 / 오른쪽 SPIMI = 블록 전용 해시 사전에 바로 붙이고, 쓸 때 term만 정렬
알고리즘
SPIMI-Invert(token_stream) output_file = NewFile() dictionary = NewHash() while (free memory available) token = next(token_stream) if term(token) not in dictionary postings_list = AddToDictionary(dictionary, term(token)) else postings_list = GetPostingsList(dictionary, term(token)) if full(postings_list) postings_list = DoublePostingsList(dictionary, term(token)) AddToPostingsList(postings_list, docID(token)) sorted_terms = SortTerms(dictionary) WriteBlockToDisk(sorted_terms, dictionary, output_file) return output_file- 사전 = 해시. 처음 보는 term이면 사전에 추가, 아니면 기존 포스팅 리스트 가져옴
- 포스팅 리스트가 꽉 차면 크기 2배로 늘림 (DoublePostingsList)
- 메모리가 남아 있는 동안 반복 → 꽉 차면 term만 정렬해서 디스크에 블록으로 씀
- term을 정렬하는 이유: 블록 병합할 때 term 순서대로 쭉 읽으려고
- 블록 병합은 BSBI랑 같음
압축
- 압축하면 SPIMI가 더 효율적: term 압축, 포스팅 압축 → ch5
BSBI vs SPIMI
BSBI SPIMI 사전 term → termID 사전 하나를 계속 유지 블록마다 새 사전 (해시) 포스팅 형태 (termID, docID) 쌍 term별 포스팅 리스트에 바로 붙임 정렬 쌍 전부 정렬 term만 정렬 (쓸 때 한 번) 블록 결과 정렬된 쌍 블록 하나짜리 완전한 역색인 병합 블록 병합 BSBI랑 같음
4.4 Distributed indexing
웹 규모 색인은 기계 한 대로 못 만듦 → 고장 잘 나는 기계 여러 대에 어떻게 나눠 맡기냐
왜 분산 색인이 필요한가
- 웹 규모는 컴퓨터 한 대로 불가 → 클러스터(distributed computer cluster)를 써야 함
- 기계 하나하나는 고장이 잦음: 예고 없이 느려지거나 죽음
- 문제: 이렇게 못 믿을 기계 묶음을 어떻게 써먹냐
구글 데이터센터 (2007 추정)
- 비싼 서버 말고 평범한 기계(commodity machine) 위주, 전 세계에 흩어져 있음
- 서버 100만 대, 프로세서·코어 300만 개, 분기마다 10만 대 추가
- 연 2~2.5억 달러 → 세계 컴퓨팅 능력의 10%
고장 계산
- 1000대 전부 살아 있을 확률 = 0.999^1000 ≈ 0.37 (37%) → 한 대만 죽어도 멈추는 시스템은 못 씀
- 서버 100만 대, 한 대가 3년에 한 번 고장 → 3년 = 3 × 365 × 24 × 60 = 1,576,800분 ÷ 1,000,000 = 1.6분 → 2분도 안 돼서 하나씩 고장
master와 병렬 작업
- master: 색인 작업 전체를 지휘하는 기계. 이건 "안 죽는다(safe)"고 가정
- 색인을 병렬 작업 여러 개로 쪼갬 → master가 노는(idle) 기계에 하나씩 맡김
- 작업 종류 2개 = 기계 종류 2개: parser, inverter
- split: 문서 컬렉션을 쪼갠 조각(문서 부분집합). BSBI·SPIMI의 블록에 해당
Parser와 Inverter
parser inverter 받는 것 split 하나 term 구간 하나 (예: a-f) 하는 일 문서 하나씩 읽어서 (term, docID) 쌍을 내보냄 그 구간의 (term, docID) 쌍(= 포스팅)을 전부 모아 정렬 결과 term 구간별 파일 j개 그 구간의 포스팅 리스트 - term-partition: term 첫 글자 범위로 나눈 구간. 예: a-f, g-p, q-z (j = 3)
- segment file: parser가 구간별로 써 둔 파일. parser 하나당 j개
MapReduce 흐름
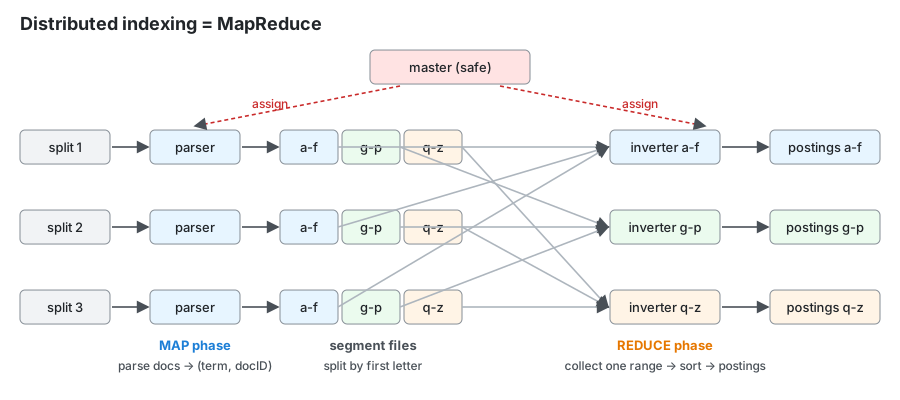
- map = parser: split(문서 묶음) → (term, docID) 쌍 → 첫 글자 구간(a-f, g-p, q-z)별 segment 파일
- reduce = inverter: 한 구간의 segment 파일을 전부 모아서 정렬 → 포스팅 리스트
- 순서: splits → map 단계(parser) → segment 파일 → reduce 단계(inverter) → 포스팅
- 그림에서: 회색 선 = inverter가 모든 parser에서 자기 구간 파일만 가져감
MapReduce
- 방금 그 색인 방법이 MapReduce의 한 예
- MapReduce: 분산 처리 부분 코드를 직접 안 짜도 되는, 튼튼하고 단순한 분산 계산 틀
- 구글 색인 시스템(2002년쯤) = 여러 단계, 단계마다 MapReduce로 구현. 색인 만들기는 그중 한 단계
- 다른 단계 예: term-partitioned 색인 → document-partitioned 색인으로 바꾸기
term-partitioned document-partitioned 나누는 법 term 구간별 (a-f 기계, g-p 기계 …) 문서 묶음별 (기계마다 자기 문서의 전체 색인) 질의 처리 질의 term 맡은 기계끼리 포스팅 주고받음 모든 기계에 보내고 결과만 합침 - 연습: 왜 document-partitioned가 나을 수 있나 → 여러 단어 질의에도 긴 포스팅 리스트를 기계끼리 안 옮겨도 됨 / 인기 term 맡은 기계에 부하가 안 몰림 / 기계 하나 죽어도 일부 문서만 빠짐
map·reduce 함수 스키마
입력 출력 map input list(k, v) reduce (k, list(v)) output 색인 map 웹 컬렉션 list(termID, docID) 색인 reduce (⟨termID1, list(docID)⟩, ⟨termID2, list(docID)⟩, …) (postings list1, postings list2, …) - k = termID, v = docID. reduce는 같은 key끼리 묶인 값 목록을 받음
MapReduce 예시 계산
- 입력:
d1: C came, C c'ed./d2: C died.
단계 결과 map (C,d2) (died,d2) (C,d1) (came,d1) (C,d1) (c'ed,d1) 묶기 C → d2, d1, d1 / died → d2 / came → d1 / c'ed → d1 reduce C → (d1:2, d2:1) / died → (d2:1) / came → (d1:1) / c'ed → (d1:1) - reduce = 같은 term끼리 docID 모아서 문서마다 몇 번 나왔는지 셈
- 입력:
연습: master와 주고받는 정보
master가 주는 것 끝나고 master에 보고하는 것 parser 맡을 split 위치, term 구간 나누는 법 (a-f, g-p, q-z) 만든 segment 파일 j개의 위치 inverter 맡을 term 구간 + 모든 parser의 그 구간 segment 파일 위치 만든 포스팅 리스트 파일 위치
4.5 Dynamic indexing
문서가 계속 추가·삭제·수정될 때 색인을 어떻게 최신으로 유지하냐
왜 필요한가
- 지금까지는 컬렉션이 고정(static)이라고 가정
- 실제론 문서가 추가(insert), 삭제(delete), 수정(modify)됨 → 사전·포스팅 리스트도 계속 바꿔야 함
제일 단순한 방법: main + aux
- main 색인: 디스크에 있는 큰 색인 / aux(auxiliary) 색인: 새 문서만 담는 메모리의 작은 색인
- 검색: 둘 다 뒤지고 결과 합침
- 주기적으로 aux를 main에 병합
- 삭제: 실제로 안 지우고 무효화 비트 벡터(invalidation bit-vector)에 1 표시 → 색인이 돌려준 결과에서 이 벡터로 걸러냄
main + aux 문제
- 병합이 자주 일어남
- 병합하는 동안 검색 성능이 나빠짐
main + aux 비용
- aux(크기 a)가 찰 때마다 디스크 main에 병합 → main 전체를 다시 씀
- 쓰는 양: a + 2a + 3a + … + na = a · n(n+1)/2 = O(n²) → 전체 포스팅 T 기준 O(T²) (포스팅 하나가 병합 때마다 매번 다시 쓰임)
- 예: a = 1, n = 4 → 1 + 2 + 3 + 4 = 10 = 4 × 5 / 2
Logarithmic merge = 이진수 +1
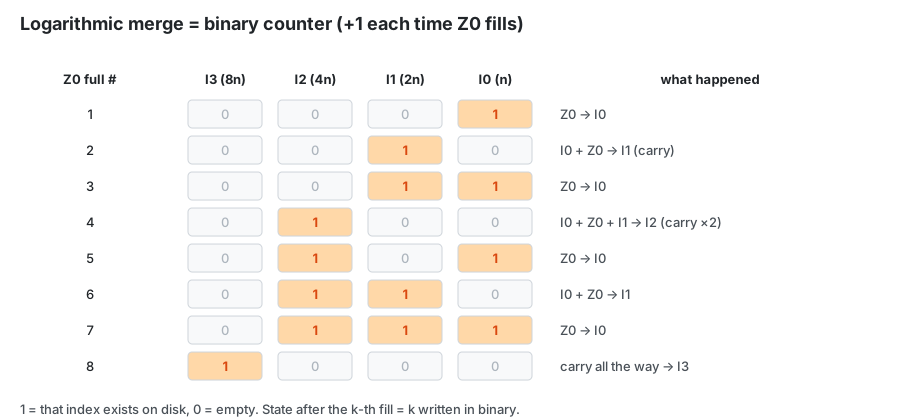
- 병합 비용을 시간에 걸쳐 나눠 냄(amortize) → 사용자가 느끼는 응답 시간 영향이 작음
- 크기 2배씩: Z0(메모리, n) / I0(n), I1(2n), I2(4n), I3(8n) … (디스크)
- Z0가 n개로 차면: I0 비었으면 → I0에 저장 / I0 있으면 → 합쳐서(2n) I1으로, I1도 있으면 또 합쳐서(4n) I2로 … 빈 칸 나올 때까지
- k번째로 찼을 때 상태 = k를 이진수로 쓴 것 (오른쪽부터 I0, I1, I2 …). 예: 4번째 = 100 → I2만 있음, 6번째 = 110 → I2, I1
- 그림에서: 주황 1 = 디스크에 그 색인 있음, 받아올림(carry) = 병합
알고리즘
LMergeAddToken(indexes, Z0, token) Z0 = Merge(Z0, {token}) if |Z0| = n for i = 0 to infinity if I_i in indexes Z_(i+1) = Merge(I_i, Z_i) indexes = indexes - {I_i} else I_i = Z_i indexes = indexes + {I_i} break Z0 = {} LogarithmicMerge() Z0 = {} indexes = {} while true LMergeAddToken(indexes, Z0, getNextToken())- token 하나씩 Z0에 넣고, Z0가 n개 차면 i = 0부터 올라감
- Ii가 있으면: 합쳐서 Z(i+1)(디스크 임시 색인) 만들고 I_i는 없앰 → 다음 i로 (받아올림)
- I_i가 없으면: Z_i가 그대로 I_i가 됨 → 멈춤
- 끝나면 Z0 비우고 다시 받음
Logarithmic merge 비용
- 색인 개수 = O(log T) → 검색할 때도 O(log T)개만 합침
- 포스팅 하나는 병합될 때마다 한 칸 위로 → 최대 log T번 → 전체 O(T log T)
main + aux logarithmic merge 색인 만드는 시간 O(T²) O(T log T) 검색 때 합칠 색인 수 2개 O(log T)개 - aux 방식보다 한 차원(order of magnitude) 더 효율적
대형 검색엔진은 실제로 어떻게 하나
- 보통 여러 방법을 섞어 씀
- 잦은 증분(incremental) 변경
- 색인 큰 덩어리를 따로 만들어 두고 통째로 갈아 끼움(rotation, swap in)
- 가끔 전체 재구축(complete rebuild). 색인이 클수록 어려움, 구글은 전체 재구축이 되는지도 불명
Positional 색인 만들기
- 문제는 거의 같음. 중간 자료구조가 훨씬 커질 뿐
ch4 정리 (take-away)