
- 작성일
CH5. Index Compression
- Authors

- Name
- seren-wib
Contents
5. Index compression
5.1 Compression
색인을 왜 압축하냐 → 공간도 줄고 속도도 빨라짐
압축하는 이유 (일반)
- 디스크 공간 절약 (돈 절약)
- 메모리에 더 많이 올림 (속도 ↑)
- 디스크 → 메모리 전송도 빨라짐: 압축된 걸 읽고 메모리에서 푸는 게 그냥 읽는 것보다 빠름
- 전제: 푸는(decompression) 알고리즘이 빠름. 이 장에서 쓰는 건 다 빠름
IR에서 압축하는 이유
대상 목표 사전 메모리에 통째로 올릴 만큼 작게 포스팅 디스크 공간 줄이기, 디스크 읽는 시간 줄이기 - 큰 검색엔진은 포스팅도 상당 부분 메모리에 둠
lossy vs lossless
- lossy: 정보 일부를 버리는 압축. 예: 소문자화, 불용어 제거, Porter 어간 추출, 숫자 제거 (ch2 전처리가 사실상 lossy 압축)
- lossless: 정보를 하나도 안 버리는 압축. 색인 압축은 주로 이것
5.2 Term statistics
압축 전에 term이 몇 개쯤 나오고(Heaps) 어떻게 분포하는지(Zipf) 알아야 함
Reuters RCV1 (ch4 4.1이랑 같은 표)
기호 항목 값 N 문서 수 800,000 L 문서당 token 수 200 M term 수 (word type) 400,000 token당 바이트 (공백·구두점 포함) 6 token당 바이트 (빼고) 4.5 term당 바이트 7.5 T non-positional 포스팅 수 100,000,000 전처리가 크기에 주는 영향 (Reuters)
- 숫자 = 그 단계에서 줄어든 % / 누적 %
단계 사전 (term 수) non-positional 포스팅 positional 포스팅 (token) 처리 안 함 484,494 109,971,179 197,879,290 숫자 제거 473,723 (−2 / −2) 100,680,242 (−8 / −8) 179,158,204 (−9 / −9) 대소문자 통일 391,523 (−17 / −19) 96,969,056 (−3 / −12) 179,158,204 (−0 / −9) 불용어 30개 391,493 (−0 / −19) 83,390,443 (−14 / −24) 121,857,825 (−31 / −38) 불용어 150개 391,373 (−0 / −19) 67,001,847 (−30 / −39) 94,516,599 (−47 / −52) 어간 추출 322,383 (−17 / −33) 63,812,300 (−4 / −42) 94,516,599 (−0 / −52) - 연습: non-positional vs positional 숫자가 왜 다르냐
- 대소문자 통일 −3 vs −0, 어간 추출 −4 vs −0: The와 the가 한 문서에 있으면 포스팅(docID) 2개 → 1개로 합쳐짐. 근데 token 개수는 그대로라 positional은 안 줄어듦
- 불용어 −14 vs −31, −30 vs −47: 불용어는 한 문서에 수십 번 나옴. non-positional은 문서당 1개만 빠지고, positional은 나온 횟수만큼 다 빠짐
- 불용어 빼도 사전은 거의 안 줄어듦 (30개, 150개 빼봤자 term 수에 비하면 0%)
Heaps' law: 어휘 크기 계산
- 어휘에 상한이 있나? 없음. 길이 20짜리 단어만 해도 70²⁰ ≈ 10³⁷개 가능 → 컬렉션이 커지면 어휘도 계속 커짐
- Heaps' law: 컬렉션 token 수로 term 수를 예측하는 경험 법칙
- M = k · T^b (M = term 수, T = token 수), 보통 30 ≤ k ≤ 100, b ≈ 0.5
- log-log 그래프에서 직선: log M = b · log T + log k (컬렉션 크기와 어휘 크기 사이 제일 단순한 관계)
- Reuters: log₁₀M = 0.49 · log₁₀T + 1.64 → k = 10^1.64 ≈ 44, b = 0.49
- 예: T = 1,000,020 → 44 × 1,000,020^0.49 ≈ 38,323 (실제 38,365) → 잘 맞음
Heaps' law 연습: k, b 구해서 M 계산
- 처음 10,000 token에 3,000 term, 1,000,000 token에 30,000 term
- 나누기: 30,000 / 3,000 = (1,000,000 / 10,000)^b → 10 = 100^b → b = 0.5
- 대입: 3,000 = k × 10,000^0.5 = k × 100 → k = 30
- 페이지 2 × 10¹⁰개 × 200 token = T = 4 × 10¹² → M = 30 × √(4 × 10¹²) = 30 × 2 × 10⁶ = 60,000,000
- 연습 1 (오타 포함 vs 자동 교정): 오타 포함하면 새 term이 계속 생겨서 M이 더 커짐 (k 또는 b가 커짐)
Zipf's law: 빈도 계산
- Heaps = 어휘가 얼마나 커지냐 / Zipf = 자주 나오는 term vs 드문 term이 몇 개냐
- Zipf's law: i번째로 많이 나오는 term의 빈도가 1/i에 비례. cf_i ∝ 1/i (cf = 컬렉션 전체 등장 횟수)
- cf₂ = cf₁ / 2, cf₃ = cf₁ / 3 … 예: the가 cf₁이면 of는 절반, and는 1/3
- cf_i = c · i^k (k = −1) → log cf_i = log c − log i → log-log에서 기울기 −1 직선 (멱법칙, power law)
- Reuters에선 직선에 딱 맞진 않음. 중요한 건 결론: 자주 나오는 term 몇 개, 드문 term 엄청 많음
5.3 Dictionary compression
사전을 메모리에 올리려면 고정 길이 칸의 낭비부터 없애야 함
사전을 왜 압축하냐
- 사전은 포스팅보다 훨씬 작음. 그래도 메모리에 둬야 함
- 다른 프로그램이랑 메모리 경쟁, 휴대폰·차량용 컴퓨터처럼 메모리 작은 기기, 빠른 시작 시간
고정 길이 배열 (ch3 3.1)
- 한 줄 = term 20 + 빈도 4 + 포스팅 포인터 4 = 28바이트 → (20 + 4 + 4) × 400,000 = 11.2 MB
- 문제
- term 칸 대부분이 낭비: 1글자 term도 20바이트
- 20글자 넘는 단어는 못 넣음 (hydrochlorofluorocarbons, supercalifragilisticexpialidocious)
- 영어 term 평균 길이는 8글자 정도 → term당 평균 8글자만 쓰게 하려면?
문자열 방식 (dictionary as a string)
- term을 전부 이어 붙인 긴 문자열 하나 + 각 줄에 term 시작 위치 포인터
- 예:
...systilesyzygeticsyzygialsyzygyszaibelyiteszecin.../ 다음 term 포인터 위치 = 지금 term 끝 - 한 줄 = 빈도 4 + 포스팅 포인터 4 + term 포인터 3 + term 평균 8바이트(문자열 안)
- term 포인터가 3바이트인 이유: 문자열 길이 8 × 400,000 = 3,200,000 → log₂(3,200,000) ≈ 21.6 < 24비트 = 3바이트
- 400,000 × (4 + 4 + 3 + 8) = 7.6 MB (고정 길이 11.2 MB보다 작음)
blocking (k = 4)
- term 4개마다 포인터 1개만 둠, 대신 term 앞에 길이 1바이트씩 붙임. 예:
7systile9syzygetic8syzygial6syzygy11szaibelyite6szecin - 블록당: 전엔 포인터 4 × 3 = 12바이트 → 이젠 포인터 3 + 길이 4 × 1 = 7바이트 → 블록당 5바이트 절약
- 전체: 400,000 / 4 블록 × 5 = 0.5 MB → 7.6 → 7.1 MB
- 대가: 찾기가 조금 느림
blocking 없음 blocking (k = 4) 찾는 법 term마다 이진 탐색 블록까지 이진 탐색 → 블록 안은 앞에서부터 차례로 예 (8 term) aid, box, ... 전부 트리 노드 [aid box den ex] [job ox pit win] 블록 2개 속도 빠름 조금 느림 - k를 키우면 공간은 더 줄고, 블록 안에서 훑는 시간은 늘어남
- term 4개마다 포인터 1개만 둠, 대신 term 앞에 길이 1바이트씩 붙임. 예:
front coding
- front coding: 블록 안 term들이 같은 접두사를 가지면 접두사를 한 번만 쓰는 것 (정렬돼 있어서 이웃끼리 접두사가 자주 같음)
8automata8automate9automatic10automation→8automat*a1◇e2◇ic3◇ion- 읽는 법:
8automat*a= 길이 8, 접두사 automat 끝은*→ automata /1◇e= 접두사 뒤에 1글자 e → automate /2◇ic→ automatic /3◇ion→ automation - 연습: 어떤 접두사를 쓸지, 트레이드오프는?
- 접두사가 길면 term마다 아끼는 글자가 많지만, 그 접두사를 공유하는 term은 적음
- 접두사가 짧으면 많은 term이 공유하지만 아끼는 글자가 적음
사전 크기 정리 (Reuters, M = 400,000)
방식 계산 크기 고정 길이 배열 (20 + 4 + 4) × 400,000 11.2 MB 문자열 + term 포인터 400,000 × (4 + 4 + 3 + 8) 7.6 MB + blocking (k = 4) 7.6 − 400,000 / 4 × 5바이트 = 7.6 − 0.5 7.1 MB + blocking + front coding 5.9 MB
5.4 Postings compression
docID 대신 차이(gap)를 저장하고, 작은 gap엔 비트를 적게 쓰는 가변 길이 코드로
포스팅을 왜 압축하냐 / docID 하나 몇 비트
- 포스팅 파일이 사전보다 최소 10배 큼 → 포스팅 하나(= docID 하나)를 작게 저장하는 게 핵심
- 4바이트 정수 = 32비트 / 필요한 만큼만: log₂ 800,000 ≈ 19.6 → 20비트
- 목표: 20비트보다 훨씬 적게
gap 저장
- 포스팅은 docID 오름차순 → 첫 docID + 앞 것과의 차이(gap)만 저장
- 예: computer 283154, 283159, 283202 → 283154, 5, 43
term docID gap the 283042, 283043, 283044, 283045 1, 1, 1 computer 283047, 283154, 283159, 283202 107, 5, 43 arachnocentric 252000, 500100 252000, 248100 - 자주 나오는 term(the)은 gap이 작음 / 드문 term(arachnocentric)은 큼
가변 길이 인코딩 (variable length encoding)
- 작은 gap엔 비트 적게, 큰 gap엔 많이 쓰는 인코딩
- 목표: arachnocentric 같은 드문 term은 gap당 20비트쯤, the 같은 흔한 term은 gap당 몇 비트만
- 방법 2가지: 바이트 단위 VB 코드 / 비트 단위 γ 코드
VB 코드 (variable byte)
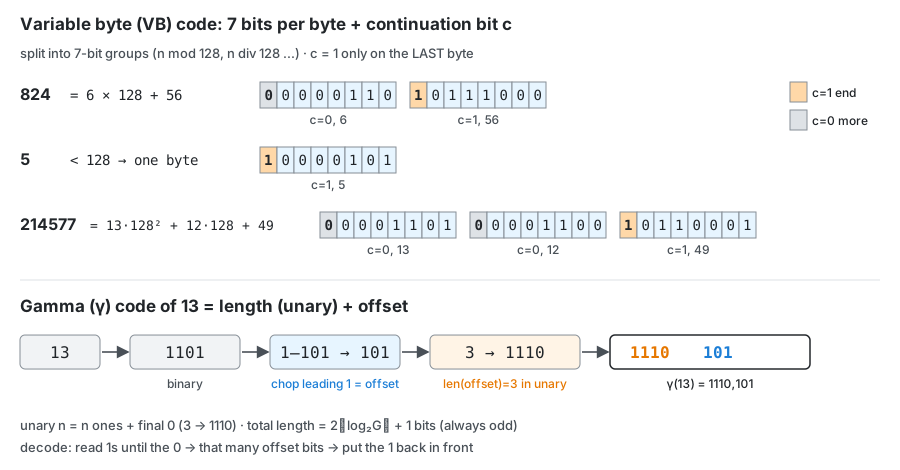
- 상용·연구 시스템에서 많이 씀. 가변 길이이면서 바이트 경계(alignment)에 맞음
- 바이트 하나 = continuation bit c 1개(맨 앞) + 숫자 7비트
- 인코딩: 128로 계속 나눠서 나머지를 뒤에서부터 채움 (7비트씩) → 마지막 바이트만 c = 1, 나머지는 c = 0
- 예: 824 = 6 × 128 + 56 →
00000110 10111000/ 5 →10000101/ 214577 = 13·128² + 12·128 + 49 →00001101 00001100 10110001 - 디코딩: n = 128 × n + (7비트 값), c = 1인 바이트 만나면 숫자 하나 끝 → n = 0으로 다시
- 연습: 130 = 1 × 128 + 2 →
00000001 10000010 - 그림에서: 위 = VB (주황 c = 1 = 마지막 바이트)
VBEncodeNumber(n) 1 bytes <- < > 2 while true 3 do Prepend(bytes, n mod 128) 4 if n < 128 5 then Break 6 n <- n div 128 7 bytes[Length(bytes)] += 128 8 return bytes VBDecode(bytestream) 1 numbers <- < > 2 n <- 0 3 for i <- 1 to Length(bytestream) 4 do if bytestream[i] < 128 5 then n <- 128 * n + bytestream[i] 6 else n <- 128 * n + (bytestream[i] - 128) 7 Append(numbers, n) 8 n <- 0 9 return numbers- VBEncodeNumber: 128로 나눈 나머지를 앞에 붙이기 반복 → 마지막 바이트에 128 더함(= c 비트 1)
- VBEncode: 숫자마다 VBEncodeNumber 해서 이어 붙임
- VBDecode: 128보다 작으면(c = 0) 계속 누적, 128 이상이면(c = 1) 128 빼고 누적 → 숫자 하나 완성
다른 가변 코드
- 바이트 말고 다른 단위(alignment)도 가능: 32비트(word), 16비트, 4비트(nibble)
- 작은 gap이 많으면 바이트 단위는 낭비 → nibble이 나음
- gap 여러 개를 word 하나에 몰아넣는 word-aligned 코드도 있음
감마(γ) 코드
- 비트 단위 코드(bitlevel code): VB보다 더 압축됨. 제일 유명한 게 γ
- unary: n → 1을 n개 + 0. 예: 3 →
1110, 40 → 1 40개 + 0 - γ = 길이(unary) + offset
- offset = 2진수에서 맨 앞 1 뗀 것: 13 →
1101→101 - 길이 = offset 비트 수를 unary로: 3 →
1110 - γ(13) =
1110,101
- offset = 2진수에서 맨 앞 1 뗀 것: 13 →
- 예: 1 →
0(offset 없음) / 2 →10,0/ 3 →10,1/ 4 →110,00/ 9 →1110,001/ 24 →11110,1000/ 511 →111111110,11111111/ 1025 →11111111110,0000000001 - 0은 γ 코드 없음 (gap은 1 이상이라 상관없음)
- 연습: 130 =
10000010→ offset0000010(7비트) → 길이 7 →11111110→ γ(130) =11111110,0000010 - 디코딩: 0 나올 때까지 1을 셈(= offset 비트 수) → 그만큼 읽고 → 앞에 1 붙여서 2진수 → 10진수
- 그림에서: 아래 = 13 → 1101 → 앞 1 떼기 → 길이 3을 unary → 붙이기
γ 코드 길이
- offset = ⌊log₂G⌋비트, 길이 = ⌊log₂G⌋ + 1비트
- 전체 = 2⌊log₂G⌋ + 1비트 → 항상 홀수. 예: 13 → 2 × 3 + 1 = 7비트
- 최적 길이 log₂G의 2배 안에 들어옴 (gap 분포에 대한 가정이 대략 맞을 때)
γ 코드 성질
- prefix-free: 어떤 코드도 다른 코드의 앞부분이 아님 → 구분자 없이 이어 붙여도 디코딩 가능 (VB도 같음)
- 최적의 3배 안 (가정 더 하면 2배 안). gap 분포와 상관없이 성립
- universal: 어떤 분포에도 쓸 수 있음
- parameter-free: 정할 파라미터 없음
γ vs VB: 정렬(alignment)
- 컴퓨터는 8, 16, 32비트 경계로 다룸 → 비트 단위로 압축·조작하면 느릴 수 있음
- VB는 바이트 경계에 맞아서 더 빠를 수 있음
VB γ 단위 바이트 비트 크기 116 MB (Reuters) 101 MB (더 작음) 속도 빠름 (정렬됨) 느릴 수 있음 구현 단순 복잡 - 공간 조금 더 쓰는 대신 VB가 개념적으로 단순함
크기 계산 (Reuters)
자료 계산 크기 (MB) 사전, 고정 길이 11.2 사전, 문자열 + term 포인터 7.6 + blocking (k = 4) 7.1 + blocking + front coding 5.9 컬렉션 (텍스트 + xml) 3,600 컬렉션 (텍스트만) 960 term-문서 incidence matrix 400,000 × 800,000비트 ÷ 8 40,000 포스팅, 압축 X (32비트) 1억 × 4바이트 400 포스팅, 압축 X (20비트) 1억 × 2.5바이트 250 포스팅, VB 116 포스팅, γ 101 - 색인 = 컬렉션 텍스트의 10~15% (위치·빈도 정보 빼고 계산한 거라 실제론 덜 줄어듦)