
- 작성일
CH6. Scoring, Term Weighting and the Vector Space Model
- Authors

- Name
- seren-wib
Contents
6. Scoring, term weighting, the vector space model
6.1 Why ranked retrieval?
불리언은 맞냐 안 맞냐만 → 문서마다 점수 매겨서 순서대로 보여주자
지금까지 질의는 불리언
- 문서가 맞거나 안 맞거나 둘 중 하나
- 좋은 쪽: 자기가 뭘 찾는지, 컬렉션이 어떤지 잘 아는 전문가 / 결과 수천 개도 그냥 받아먹는 프로그램
- 안 좋은 쪽: 대부분의 사용자. 불리언 식을 못 쓰거나 귀찮아함, 결과 수천 개 훑어보기 싫어함 (특히 웹 검색)
불리언 검색 문제: feast or famine
- 결과가 너무 많거나(200,000개) 0개 → 적당한 개수 나오는 질의 만들기 어려움
- 예:
[standard user dlink 650]→ 200,000개 (feast) /[standard user dlink 650 no card found]→ 0개 (famine) - 단어 몇 개 더 AND했을 뿐인데 20만 → 0. 적당한 개수 맞추려면 기술이 필요함
순위 검색(ranked retrieval)이면 문제 없음
- 결과 많아도 상위 10개만 보여주면 됨 → 사용자가 안 질림
- 전제: 순위 알고리즘이 제대로 돌아야 함 (관련 있는 문서가 위로)
점수가 순위 검색의 바탕
- 방법: 질의-문서 쌍마다 점수(0~1) 매기고 점수순 정렬. 점수 = 질의랑 문서가 얼마나 잘 맞냐
- 점수 조건: 질의 term이 하나도 없으면 0 / 질의 term이 문서에 많이 나올수록, 질의 term이 많이 들어 있을수록 높게
- 점수 매기는 방법 여러 개를 차례로 봄: Jaccard(6.1) → tf(6.2) → tf-idf(6.3) → 코사인(6.4)
Jaccard 계수 계산
- jaccard(A, B) = |A ∩ B| / |A ∪ B| (집합 겹침 비율, 0~1). jaccard(A, A) = 1, 안 겹치면 0
- A, B 크기가 달라도 됨, 항상 0~1 사이 값
- 예: q "ides of March" = {ides, of, march}, d "Caesar died in March" = {caesar, died, in, march} → ∩ = {march} 1개, ∪ = 6개 → 1/6
Jaccard의 문제
- term 빈도 무시: march가 1번 나오든 10번 나오든 똑같음
- 드문 term이 더 중요한 걸 무시: the랑 arachnocentric이 똑같이 1개
- 길이 정규화가 별로: 나중에 |A ∩ B| / √|A ∪ B| (코사인, 6.4)로 바꿈
6.2 Term frequency
문서에 질의 term이 몇 번 나왔냐를 점수에 넣자
행렬: 0/1 → 횟수
- binary incidence matrix: 있으면 1, 없으면 0 (ch1 행렬). 문서 = 0/1 벡터
- count matrix: 등장 횟수. 예: Anthony in Anthony and Cleopatra = 157. 문서 = 횟수 벡터
Anthony and Cleopatra Julius Caesar The Tempest Hamlet Othello Macbeth Anthony 157 73 0 0 0 1 Brutus 4 157 0 2 0 0 Caesar 232 227 0 2 1 0 Calpurnia 0 10 0 0 0 0 Cleopatra 57 0 0 0 0 0 mercy 2 0 3 8 5 8 worser 2 0 1 1 1 5 Bag of words
- bag of words: 단어 순서 무시하고 몇 번 나왔는지만 봄. "John is quicker than Mary" = "Mary is quicker than John"
- positional 색인(ch2 2.4)은 이 둘을 구분했으니까 한 발 후퇴
- 위치 정보는 나중에 다시 살림, 지금은 bag of words로 감
term frequency (tf)
- tf_t,d: term t가 문서 d에 나온 횟수
- 그대로 쓰면 안 됨: tf 10이 tf 1보다 관련 있지만 10배는 아님 → 관련도는 tf에 비례해서 안 늘어남
log 빈도 가중치
- log로 눌러줌: w_t,d = 1 + log₁₀ tf_t,d (tf > 0), 0 (tf = 0)
tf 0 1 2 10 1000 w 0 1 1.3 2 4 - tf 점수 = 질의와 문서에 둘 다 있는 term마다 (1 + log tf_t,d) 더하기. 하나도 없으면 0
연습: Jaccard vs tf 점수
질의 문서 Jaccard tf 점수 information on cars all you've ever wanted to know about cars ∩ 1 / ∪ 10 = 0.1 cars 1 → 1 information on cars information on trucks, information on planes, information on trains ∩ 2 / ∪ 6 = 0.33 (1 + log 3) × 2 = 2.95 red cars and red trucks cops stop red cars more often ∩ 2 / ∪ 8 = 0.25 red 1 + cars 1 = 2 - 집합은 중복 없이 셈 (information 3번 → 1개)
6.3 tf-idf weighting
문서 안 빈도(tf)에 더해, 컬렉션에서 드문 term일수록 가중치를 더 주자(idf)
문서 안 빈도 vs 컬렉션 빈도
- tf = 그 문서 안에서 몇 번 / 여기에 컬렉션 전체에서 얼마나 흔하냐도 가중치에 넣음
드문 term vs 흔한 term
- 드문 term이 더 정보가 많음. 예: arachnocentric이 들어간 문서면 관련 있을 확률이 아주 높음 → 가중치 크게
- 흔한 term(good, increase, line)도 있는 게 없는 것보다는 낫지만 확실한 단서는 아님 → 가중치 양수지만 작게
- 이걸 df로 반영함
idf 계산
- df_t: term t가 들어 있는 문서 수. 클수록 흔한 term = 정보가 적음 (거꾸로 된 척도)
- idf_t = log₁₀ (N / df_t) (N = 전체 문서 수). 클수록 정보 많은 term
- N / df 그대로 말고 log로 효과를 누그러뜨림(dampen). tf도 df도 둘 다 log 씀
- 예 (N = 1,000,000):
term df idf calpurnia 1 6 animal 100 4 sunday 1,000 3 fly 10,000 2 under 100,000 1 the 1,000,000 0 - 계산 요령: N / df에서 0 개수 세기. 1,000,000 / 100 = 10⁴ → 4
idf가 순위에 미치는 영향
- idf는 질의 term이 2개 이상일 때만 순위에 영향 (term 1개면 모든 문서에 같은 값을 곱하는 거라 순서 안 바뀜)
- 예: "arachnocentric line" → arachnocentric 비중 ↑, line 비중 ↓
cf vs df
- cf_t (collection frequency): 컬렉션 전체에서 t가 나온 횟수 / df_t: t가 들어 있는 문서 수
- 예: insurance cf 10440, df 3997 / try cf 10422, df 8760 → cf는 비슷한데 insurance는 적은 문서에 몰려 나옴 → insurance가 더 좋은 검색어 → 가중치는 df(idf)로
이름 기호 뜻 term frequency tf_t,d 문서 d 안에서 t가 나온 횟수 document frequency df_t t가 들어 있는 문서 수 collection frequency cf_t 컬렉션 전체에서 t가 나온 횟수 - 관계: df ≤ cf (한 문서에 여러 번 나와도 df는 1) / cf_t = 모든 문서의 tf_t,d 합 / tf_t,d ≤ cf_t
tf-idf
- w_t,d = (1 + log tf_t,d) × log (N / df_t) = tf 가중치 × idf 가중치
- IR에서 제일 유명한 가중치 방식. 다른 이름: tf.idf, tf x idf
- 문서 안에 많이 나올수록 ↑ (tf), 컬렉션에서 드물수록 ↑ (idf)
- 행렬 칸도 횟수 → tf-idf 실수로 바뀜: binary → count → weight 행렬. 문서 = 실수 벡터 (6.4로 이어짐)
6.4 The vector space model
문서도 질의도 tf-idf 벡터로 놓고, 질의랑 방향이 비슷한 문서부터 보여주자
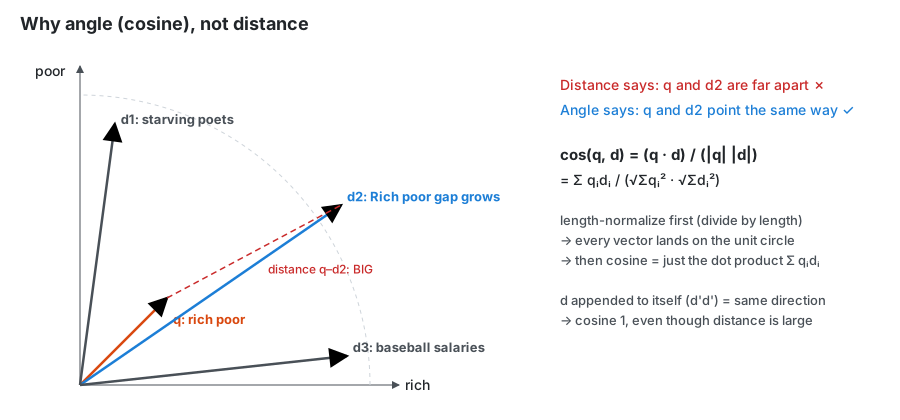
문서·질의 = 벡터
- 문서 = tf-idf 실수 벡터, term 하나 = 축 하나 (|V|차원 공간)
- 문서 = 그 공간의 점(벡터)
- 차원이 엄청 큼 (웹이면 수천만), 대부분 칸이 0 (희소, sparse)
- 핵심 1: 질의도 똑같이 벡터로 / 핵심 2: 질의와 가까운(비슷한) 문서부터 순위
- 불리언의 "맞냐 안 맞냐", feast or famine에서 벗어나려고 하는 것
거리는 안 됨 → 각도
- 거리(유클리드)는 X: 벡터 길이가 다르면 거리가 큼
- 예: q [rich poor], d2 "Rich poor gap grows" → term 분포는 거의 같은데 거리는 멂
- d를 두 번 이어 붙인 d'도 내용은 같은데 거리는 멀어짐. 각도는 0 (최대로 비슷) → 각도로 비교
- 각도 작을수록 비슷 = 코사인 클수록 비슷 (0~180°에서 코사인은 감소함수) → 각도 오름차순 = 코사인 내림차순
- 그림에서: q와 d2는 점선(거리)은 길지만 같은 방향 → 코사인으로는 가장 비슷
길이 정규화 (length normalization)
- 각 값 ÷ 벡터 길이(L2 norm, √제곱합) → 길이 1 (단위 구 위로)
- 긴 문서, 짧은 문서 가중치가 비슷한 크기가 됨
- d랑 d'(d 두 번)은 정규화하면 완전히 같은 벡터
코사인 계산
- cos(q, d) = Σ qᵢdᵢ / (√Σqᵢ² × √Σdᵢ²) (qᵢ, dᵢ = term i의 tf-idf 가중치)
- = 위는 dot product, 아래는 두 벡터 길이 곱 = q와 d 사이 각도의 코사인
- 정규화된 벡터끼리는 코사인 = 그냥 곱해서 더하기 (dot product)
예: 소설 3권 (idf 없이 log tf + 코사인 정규화)
term SaS tf PaP tf WH tf SaS w PaP w WH w SaS 정규화 PaP 정규화 WH 정규화 affection 115 58 20 3.06 2.76 2.30 0.789 0.832 0.524 jealous 10 7 11 2.00 1.85 2.04 0.515 0.555 0.465 gossip 2 0 6 1.30 0 1.78 0.335 0 0.405 wuthering 0 0 38 0 0 2.58 0 0 0.588 - SaS = Sense and Sensibility, PaP = Pride and Prejudice, WH = Wuthering Heights
- 순서: tf → 1 + log tf → 길이 구해서 나누기. SaS 길이 = √(3.06² + 2.00² + 1.30²) = √15.05 ≈ 3.88 → 3.06 / 3.88 = 0.789
- cos(SaS, PaP) = 0.789 × 0.832 + 0.515 × 0.555 + 0.335 × 0 + 0 × 0 ≈ 0.94
- cos(SaS, WH) ≈ 0.79 / cos(PaP, WH) ≈ 0.69
- SaS-PaP가 더 큰 이유: 둘 다 affection 비중이 크고 wuthering이 0. WH는 wuthering이 커서 방향이 다름
CosineScore 알고리즘
CosineScore(q) Scores[N] = 0 for each query term t calculate w(t,q), fetch postings list for t for each (d, tf(t,d)) in postings list Scores[d] += w(t,d) * w(t,q) for each d Scores[d] = Scores[d] / Length[d] return top K of Scores[]- term 하나씩 포스팅 돌면서 문서 점수에 (문서 가중치 × 질의 가중치) 누적 → 마지막에 문서 길이로 나눔 → 상위 K개
SMART 표기 ddd.qqq
- tf-idf에도 변형이 여러 개 → 글자 3개로 표시 = tf / df / 정규화. 앞 3개 = 문서, 뒤 3개 = 질의
- 질의랑 문서에 다른 가중치를 쓰는 경우가 많음
자리 글자 뜻 tf n 그대로 tf tf l 1 + log tf tf a 0.5 + 0.5 × tf / max tf tf b 있으면 1, 없으면 0 df n 안 씀 (1) df t idf = log (N / df) 정규화 n 안 함 정규화 c 코사인 (√제곱합으로 나눔) - 슬라이드 표엔 더 있음: tf L(log ave), df p(prob idf), 정규화 u(pivoted unique), b(byte size). 기본값은 가중치 없음
- lnc.ltn = 문서: log tf, idf 없음, 코사인 정규화 / 질의: log tf, idf, 정규화 없음
- 문서에 idf 안 곱해도 되나? → 질의 쪽에서 idf를 곱하니까 곱한 결과엔 idf가 한 번 들어감
예: lnc.ltn (N = 1,000,000)
- 질의 "best car insurance", 문서 "car insurance auto insurance"
term 질의 tf 질의 w(tf) df idf 질의 가중치 문서 tf 문서 w(tf) 문서 정규화 곱 auto 0 0 5000 2.3 0 1 1 0.52 0 best 1 1 50000 1.3 1.3 0 0 0 0 car 1 1 10000 2.0 2.0 1 1 0.52 1.04 insurance 1 1 1000 3.0 3.0 2 1.3 0.68 2.04 - 질의 쪽: 1 + log tf → × idf (정규화 X)
- 문서 쪽: 1 + log tf → 길이 √(1² + 0² + 1² + 1.3²) = √3.69 ≈ 1.92로 나눔 (idf X)
- 점수 = 곱의 합 = 0 + 0 + 1.04 + 2.04 = 3.08
벡터 공간 모델 순위 검색 정리
- 질의를 tf-idf 벡터로
- 문서마다 tf-idf 벡터로
- 질의 벡터와 문서 벡터마다 코사인 계산
- 코사인 순으로 순위
- 상위 K개(예: K = 10)를 보여줌
ch6 정리 (take-away)
- 순위가 중요한 이유: 순서 없는 불리언 결과 대신 좋은 것부터 (6.1)
- tf: 순위의 핵심 재료 (6.2)
- tf-idf: 제일 유명한 전통 순위 방식 (6.3)
- 벡터 공간 모델: 불리언, 확률 모델과 함께 IR의 중요한 형식 모델 (6.4)