
- 작성일
CH7. Scores in a Complete Search System
- Authors

- Name
- seren-wib
Contents
7. Scores in a complete search system
7.1 Why rank?
순위가 왜 그렇게 중요하냐 → 사용자는 위쪽 몇 개만 보니까
순위가 중요한 이유 (ch6 6.1에서 이어짐)
- 사용자는 결과 수천 개 말고 몇 개만 보고 싶어함
- 결과가 몇 개만 나오는 질의를 쓰는 건 전문가한테도 어려움
- 순위 = 큰 결과 집합을 아주 작은 집합으로 줄여주는 것 (상위 몇 개만 보면 되니까)
실험으로 확인 (구글 Dan Russell, 2007)
- 통제된 환경에서 검색하는 사람을 관찰: 녹화, 소리 내어 생각하기(think aloud), 인터뷰, 시선 추적(eye-tracking), 시간 재기, 클릭 세기
결과
- 요약 읽기: 1~4위 요약을 7~10위보다 훨씬 많이 읽음
- 클릭: 읽기보다 더 위로 쏠림
- 2번 중 1번은 1위 클릭, 1위가 관련 없어도 30%는 1위 클릭
- 결론: 순위를 맞히는 게 중요하고, 1위를 맞히는 게 제일 중요
연습: 순위가 신규 검색엔진의 진입 장벽인 이유
- 좋은 순위를 만들려면 사용자 클릭·질의 기록이 많이 필요함 → 사용자가 많은 기존 업체만 계속 좋아짐 → 신규는 따라잡기 어려움
7.2 More on cosine
길이 정규화를 코사인으로 하면 짧은 문서가 유리해짐 → pivot normalization으로 보정
거리 대신 코사인 쓰는 이유 (ch6 6.4 복습)
- q [rich poor], d2 "Rich poor gap grows" → 단어 분포는 거의 같은데 유클리드 거리는 큼
- 그래서 길이 정규화 = 코사인으로 점수 계산
연습: 코사인 정규화의 문제
- q "anti-doping rules Beijing 2008 olympics"
- d1 = 2008 올림픽 도핑 규칙 짧은 문서 / d2 = d1 + 상관없는 기사 5개(긴 문서) / d3 = 2004 아테네 도핑 짧은 문서
- 코사인은 긴 d2를 손해 보게 함 (d1 내용이 그대로 들어 있는데도 d2 점수 낮음) → d3보다도 밀릴 수 있음
Pivot normalization
- 코사인 정규화는 평균적으로 짧은 문서엔 가중치가 너무 크고 긴 문서엔 너무 작음
- 그래프: x = 문서 길이, y = 관련 있을 확률. 실제 확률은 긴 문서일수록 더 높은데 코사인이 예측한 확률은 그보다 낮음 → 두 선이 만나는 길이 = pivot
- 보정: 정규화 선을 pivot을 중심으로 돌림(선형 조정)
- 효과: 짧은 문서 점수 ↓, 긴 문서 점수 ↑ → 짧은 문서의 부당한 이득을 없앰
- Amit Singhal 실험: pivot 정규화로 찾은 관련 문서 수·평균 정밀도가 올라감
7.3 The complete search system
지금까지 배운 부품들을 모아서 검색 시스템 하나 만들기
계층 색인 (tiered index)
- 중요도별로 색인을 여러 층으로 나눔. 예: tier 1 = 제목 색인, tier 2 = 나머지 본문 (제목에 검색어 있는 페이지가 본문에만 있는 페이지보다 좋은 결과)
- 처리: tier 1부터 → 결과가 k개(예: 100) 이상이면 멈춤 → 모자라면 다음 tier
- 슬라이드 예: tier 1 = auto → Doc2 / car → Doc1, Doc3 / insurance → Doc2, Doc3, tier 2 = best → Doc1, Doc3, tier 3 = auto → Doc1 / car → Doc2
- 구글 초기(2000~01) 검색 품질이 경쟁사보다 높았던 이유 중 하나로 봄 (PageRank, anchor text, 근접 조건과 함께)
계층 설계 기준 (연습)
- 각 tier는 다음 tier보다 10배쯤 작게
- 대부분 질의의 top 100이 tier 1에서 끝나야 함, 나머지 질의 대부분은 tier 2에서
- "여기서 멈춰도 되나" 판단이 간단해야 함
- 매번 거의 모든 tier를 뒤져야 하면 나눌 의미 없음
검색 시스템 구성 요소
지금까지 배운 것 아직 안 배운 것 문서 전처리 (ch2) 문서 캐시: 검색 결과 요약(snippet) 만들 때 씀 positional 색인 (ch2) zone 색인: 본문·강조 글자·anchor text·메타데이터를 따로 색인 tiered 색인 (7.3) 기계학습 순위 함수 철자 교정 (ch3) proximity 순위: 질의 term이 가까이 붙어 있는 문서를 위로 wildcard·철자 교정용 k-gram 색인 (ch3) 질의 파서 질의 처리, 문서 점수 (ch1, ch6) 벡터 공간 검색과 섞을 때 문제
7.4 Implementation of ranking
점수 계산을 빠르게: 포스팅에 tf 넣기 → top k만 고르기 → 다 안 보고 일찍 끝내기
포스팅에 tf 저장
- 포스팅 = (docID, tf). 예: Brutus → (1,2) (7,3) (83,1) (87,2) / Caesar → (1,1) (5,1) (13,1) (17,1) / Calpurnia → (7,1) (8,2) (40,1) (97,3)
- tf는 정수로 저장 (log 가중치 실수는 압축이 어려움). 포스팅당 1바이트 이하 추가
- 위치(position)도 필요하지만 여기선 생략
top k 고르기: min heap
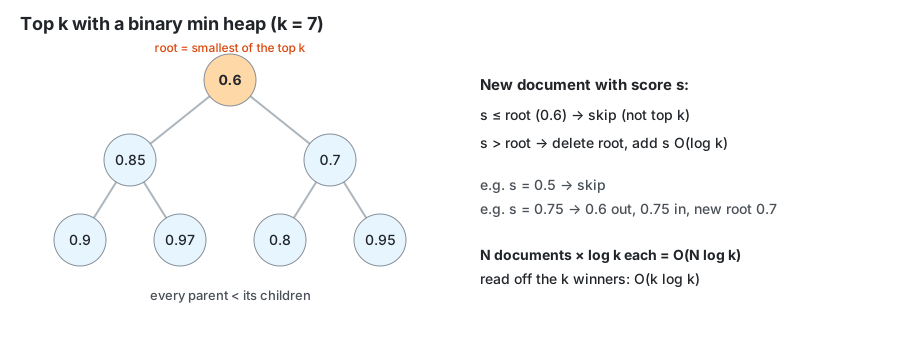
- 순위는 전부 필요 없고 top k(예: 100)만 있으면 됨
- 단순한 방법: N개 전부 점수 계산 → 정렬 → 앞 k개 → 비효율
- min heap: 이진 트리, 부모 < 자식 → 루트 = top k 중 최솟값
- 크기 k짜리 heap에 지금까지 top k 유지. 새 문서 점수 s: s ≤ 루트 → 버림 / s > 루트 → 루트 빼고 s 넣기 (O(log k))
- 루트 확인 O(1), 전체 만들기 O(N log k), 마지막에 k개 꺼내기 O(k log k)
- 그림에서: k = 7, 루트 0.6. s = 0.5면 버림, s = 0.75면 0.6 빠지고 0.75 들어감 → 새 루트 0.7
더 빠르게? (휴리스틱)
- 순위 계산 자체는 O(N), N > 10¹⁰. 최적화해도 상수만 줄지 여전히 O(N)
- 하는 일 = 질의 벡터의 kNN(k-nearest neighbor) 문제. 정확하면서 N보다 빠른(sublinear) 일반 방법은 없음
- 아이디어 1: 포스팅을 docID 말고 "기대 관련도" 순으로 정렬 (4번, 6번)
- 아이디어 2: 탐색 범위 가지치기 → 가끔 틀리지만 드묾, 실제론 거의 상수 시간. 이걸 하려면 document-at-a-time / term-at-a-time 개념이 필요 (5번)
PageRank 순 포스팅 + 조기 종료 계산
- PageRank g(d): 질의와 상관없는 페이지 "좋음" 점수. 좋은 페이지가 d에 링크를 많이 걸수록 큼 (ch21)
- 포스팅을 g(d) 큰 순으로 정렬: g(d1) > g(d2) > g(d3) > …
- net-score(q, d) = g(d) + cos(q, d)
- 조기 종료(early termination): 포스팅을 끝까지 안 봐도 top k를 찾음
- 조건: g ∈ [0, 1], 지금 문서 g(d) < 0.1, 지금까지 top k 최솟값 = 1.2
- 뒤 문서들은 g < 0.1 (정렬돼 있으니까), cos ≤ 1 → net-score < 0.1 + 1 = 1.1 < 1.2 → 더 봐도 top k에 못 들어감 → 멈춤
document-at-a-time vs term-at-a-time
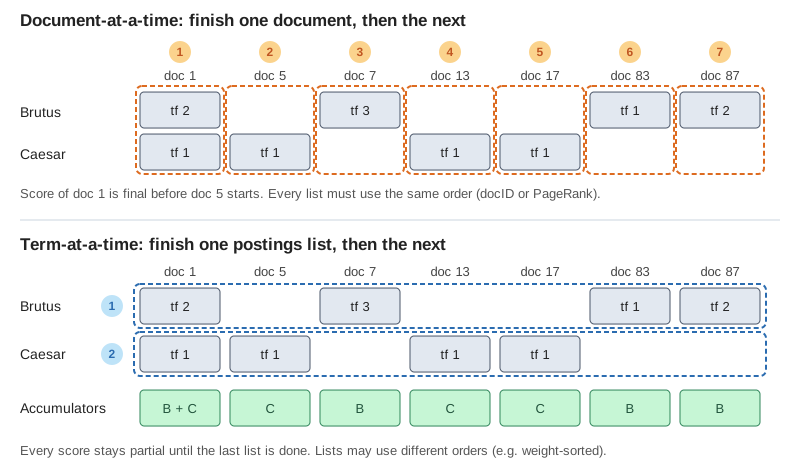
- document-at-a-time: 문서 di의 점수를 끝까지 계산하고 나서 d(i+1) 시작
- docID 순, PageRank 순 둘 다 모든 포스팅 리스트에 같은 순서를 줌 → 이 방식 가능
- term-at-a-time: 첫 질의 term 포스팅 리스트를 전부 처리 → 둘째 term 리스트 전부 → …
- 처음 보는 docID마다 accumulator(누적 점수 칸) 하나 만들고 계속 더함
- 그림에서: 위 = 주황 열(문서) 1 → 7 순서, 열 하나 끝나면 그 문서 점수 확정 / 아래 = 파란 행(term) 1 → 2 순서, 초록 accumulator는 마지막 행까지 끝나야 확정 (B + C = Brutus, Caesar 둘 다 더해짐)
document-at-a-time term-at-a-time 순서 문서 하나의 점수를 끝까지 계산 → 다음 문서 첫 term 포스팅 전부 처리 → 둘째 term 포스팅 전부 … 조건 모든 포스팅이 같은 순서(docID 순 or PageRank 순) 포스팅 순서가 term마다 달라도 됨 중간값 문서 하나 점수만 문서마다 accumulator (CosineScore의 Scores[])- term-at-a-time 코드 = ch6 6.4 CosineScore 그대로.
Scores[]칸 하나하나가 accumulator
CosineScore(q) 1 float Scores[N] = 0 2 float Length[N] 3 for each query term t 4 do calculate w(t,q) and fetch postings list for t 5 for each pair(d, tf(t,d)) in postings list 6 do Scores[d] += w(t,d) * w(t,q) 7 Read the array Length 8 for each d 9 do Scores[d] = Scores[d] / Length[d] 10 return Top k components of Scores[]- document-at-a-time: 문서 di의 점수를 끝까지 계산하고 나서 d(i+1) 시작
Weight-sorted 포스팅
- 아이디어: 최종 점수에 별로 안 보태는 포스팅은 처리 안 함
- 포스팅을 가중치 큰 순으로 정렬. 제일 단순하게는 정규화 tf-idf (실제론 드묾: 실수 가중치는 압축이 어려움)
- top k 문서가 앞쪽에 몰림 → 뒤쪽 안 보고 끝내도(조기 종료) top k가 거의 안 바뀜
- 대가: 문서마다 가중치가 term별로 달라서 포스팅마다 순서가 달라짐 → document-at-a-time 불가 → term-at-a-time
accumulator 계산
- 웹(문서 200억 개)이면
Scores[N]배열 전부는 메모리에 못 둠 → 포스팅에 나오는 문서만 accumulator 생성 - = 점수 0인 문서(질의 term이 하나도 없는 문서)는 안 만듦
- 예: 위 1번 포스팅, 질의 [Brutus Caesar]
처리 순서 새로 만드는 accumulator 이미 있어서 더하기만 Brutus 포스팅 1, 7, 83, 87 Caesar 포스팅 5, 13, 17 1 - 합집합 = 1, 5, 7, 13, 17, 83, 87 (7개). 3, 8 등은 안 만듦 (8은 Calpurnia에만 있음)
- 웹(문서 200억 개)이면
conjunctive 검색 강제
- conjunctive (AND): 모든 질의 term이 있는 문서만 보고 accumulator도 그 문서만 만듦 (구글 방식)
- 위 예: Brutus, Caesar 둘 다 있는 건 d1뿐 → 교집합 = accumulator 1 하나만
정리
- 컬렉션 문서 전부 점수 계산하면 순위는 아주 비쌈
- 근데 대부분 문서는 질의에 대해 점수 0 → 빠르게 할 여지가 많음
- 그래도 항상 정확한 빠른 최근접 이웃 알고리즘은 없음 → 실제론 휴리스틱으로 탐색 범위를 줄임, 대체로 잘 됨